Google 測試 Hydrogen、Meta 推 Muse Ember
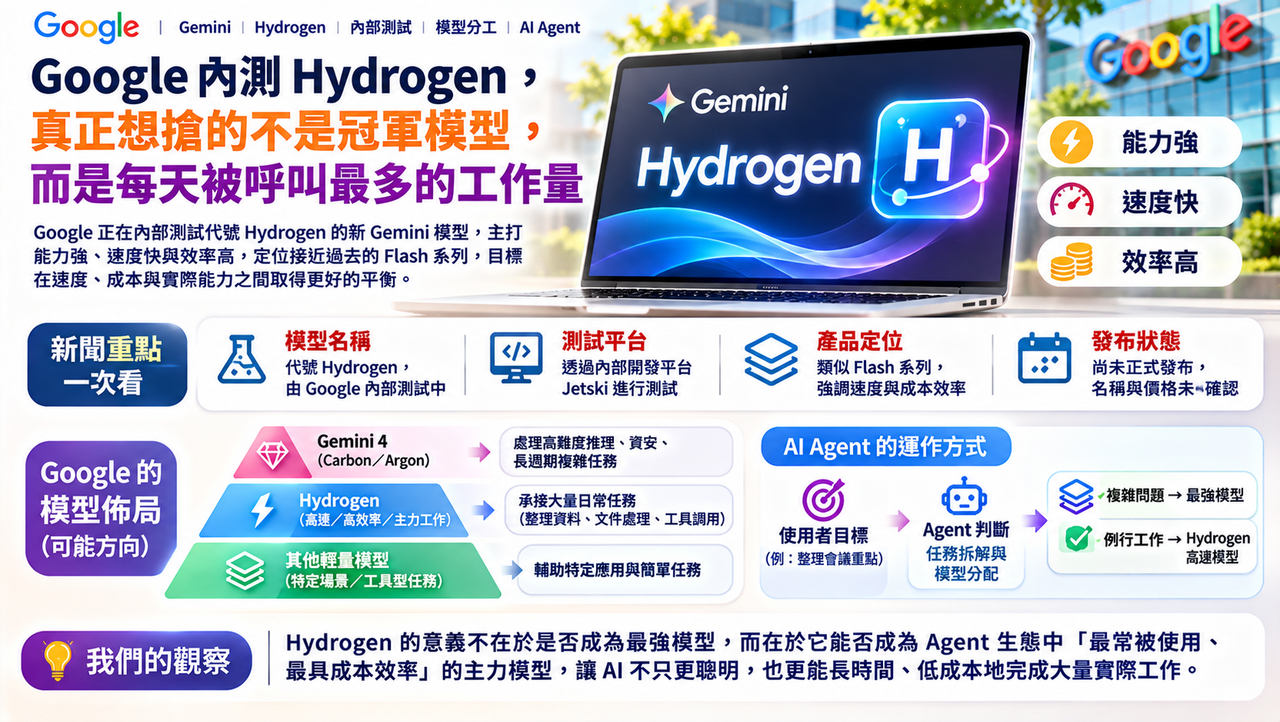
Google 內測 Hydrogen,真正想搶的不是冠軍模型,而是每天被呼叫最多的工作量
新聞重點
Google 正在內部測試代號 Hydrogen 的新 Gemini 模型。根據《Business Insider》取得的內部資訊,Google 員工已能透過名為 Jetski 的開發平台測試這款模型,一名工程師形容 Hydrogen 具有能力強、速度快與效率高等特色。
目前公開資訊顯示,Hydrogen 的產品定位比較接近 Google 過去的 Flash 系列,也就是不追求每一項能力都超越最前沿模型,而是希望在速度、成本與實際能力之間取得更好的平衡。相較之下,Google 最新的 Gemini 4 Carbon、Gemini 4 Argon 等模型,更偏向高難度推理、資安與長週期任務。
Hydrogen 尚未正式發布,Google 也沒有確認最終名稱、價格或是否會免費提供,因此目前應視為內部測試中的模型,而不是已經確定上市的 Gemini 新成員。
背景脈絡
小模型或高速模型過去容易被理解成「能力比較差的便宜版本」,但 Agent 普及後,它們的位置正在發生變化。
一個 Agent 完成任務時,並不是每一步都需要最強模型。整理一筆資料、判斷下一個工具要呼叫什麼、從文件中擷取地址或把內容轉換成特定格式,都可能只是相對單純的工作。如果每一個步驟都呼叫最昂貴的前沿模型,系統成本很快就會失控。
因此真正成熟的 Agent 架構,會更像一個團隊。複雜問題交給能力最強的模型,例行工作則分給速度快、成本低的模型。Hydrogen 如果最終沿著這條路推出,它的重要性未必比 Gemini 旗艦模型低,因為它有機會承接的是數量最大的日常工作。
知識點補充
這種設計常涉及 Model Routing,模型路由。系統在收到任務後,不是固定把所有問題送給同一個模型,而會先判斷任務複雜度,再選擇速度、價格與能力最適合的模型。
例如一份企業報告需要完成二十個步驟,其中真正困難的策略分析可能只占三個步驟,其餘大量工作只是資料整理與格式處理。如果每一步都使用最強模型,就像公司要求執行長親自處理每張報帳單,能力雖然足夠,成本卻完全不合理。
因此下一階段模型競爭的重要指標,會逐漸從「單次回答多強」增加到「完成一整項任務需要多少錢」。
生活化說法
餐廳不會讓主廚親自完成所有工作。設計菜單與處理最困難的料理需要主廚,但洗菜、備料與整理餐具會由不同人負責,才能讓整間餐廳有效率地運轉。
Agent 系統也正在走向這種分工。最強模型處理真正需要深度判斷的事情,Hydrogen 這類高速模型則可能負責大量重複工作,整體成本才壓得下來。
我們的觀察
Google 測試 Hydrogen 的意義,在於「Flash 路線」可能從輔助產品變成 AI 商業模式的重要核心。
當數億人一天只問幾次問題時,單次推理成本還容易控制;未來如果每個人都有全天候 Agent,在背景不停查看郵件、文件與工具,一個使用者每天可能產生數百甚至數千次模型呼叫。這時候每次便宜幾分錢,放大到全球規模都可能成為巨額成本差異。
所以模型競爭開始出現兩條戰線:前沿模型負責證明公司技術天花板,高效率模型則決定這套技術能不能真正大量普及。
對一般讀者的影響
未來使用 Gemini、ChatGPT 或其他 Agent 時,背後可能早已不是固定由同一款模型處理所有事情。系統可能自動把簡單任務交給便宜模型,真正困難的問題再升級到更強模型。
一般使用者未必會感覺到切換過程,但最終會反映在回應速度、訂閱價格與使用額度上。模型愈會分工,Agent 才愈可能做到長時間運作而不讓成本失控。
Claude Mythos 三天完成 AMD GPU 移植,AI 開始自己處理「AI 硬體適配」
新聞重點
Anthropic 最新 IPO 路演資料揭露一項相當特殊的工程案例:Claude Mythos Preview 協助團隊將另一款 Claude 模型移植到 AMD Instinct MI355X GPU,限定範圍的工作約三天完成。
Anthropic 表示,在這次移植中,接近全部的 GPU Kernel 都由 Claude 協助撰寫或轉換。GPU Kernel 是直接控制加速器執行特定運算的底層程式,通常需要工程師針對晶片架構進行最佳化,因此也是不同 GPU 平台之間很難直接搬移的部分。
不過,這個「三天」有明確技術範圍。Anthropic 的資料顯示,成果主要是讓單一模型在 MI355X 上,以可用效能執行 Prefill,也就是推論前段處理輸入內容的工作,並不等於三天完成完整模型訓練、推論、叢集通訊與大規模正式部署。
Anthropic 目前也在 AWS Trainium、Google TPU、NVIDIA GPU 與 AMD GPU 等多種硬體平台運作模型,顯示降低單一晶片供應商依賴,已成為公司算力策略的一部分。
背景脈絡
NVIDIA 在 AI 晶片市場最強的優勢之一,從來就不只是 GPU 本身,而是 CUDA。
CUDA 經過多年累積,已經建立大量數學函式庫、開發工具、程式框架與工程師經驗。企業即使找到另一款價格或性能具有競爭力的晶片,也可能因為現有程式全部圍繞 CUDA 開發,而不敢輕易搬家。
換句話說,硬體轉換成本本身就是 NVIDIA 的護城河。
Claude Mythos 的案例有意思之處,就是 AI Coding Agent 開始碰到這道牆。如果模型真的能大量自動處理 Kernel 重寫與平台相容工作,競爭對手的晶片即使沒有 CUDA 多年累積的工程生態,也可能降低企業嘗試替代平台的門檻。
知識點補充
GPU Kernel 不是作業系統裡通常談的核心 Kernel,而是在 GPU 上執行某項平行計算的小型程式。
大型 AI 模型需要大量矩陣運算、記憶體搬移與注意力計算,這些工作都必須依照不同 GPU 的硬體特色進行最佳化。NVIDIA、AMD 或其他加速器在指令、記憶體結構與工具鏈上存在差異,因此程式通常不能直接複製貼上。
另一個重要詞是 Prefill。大型模型進行推論時,通常先讀取完整輸入內容並建立內部狀態,這一段稱為 Prefill;之後才是逐步產生輸出的 Decode 階段。
所以 Anthropic 目前展示的是一個很重要的硬體移植成果,但不是「AMD 已全面取代 CUDA」的證明。
生活化說法
假設一家公司所有工廠設備都使用同一種控制系統,累積了十年的程式與操作經驗。即使另一家設備價格更便宜,公司也不一定願意換,因為重新改寫全部控制程式可能需要半年。
如果 AI 能把這半年工程中的大量轉換工作壓縮到幾天,採購部門就會多一個選擇。
真正被改變的不是哪台機器突然變快,而是「換機器的代價」降低了。
我們的觀察
這項能力如果持續成熟,可能比單純 AI 幫工程師寫 App 更具產業影響力。
NVIDIA 的優勢長期建立在硬體、CUDA、NVLink、NCCL 與開發者生態共同形成的完整體系,短期內不可能因一項 Demo 消失。但如果 AI 能逐漸自動完成平台移植、效能調校與 Kernel 最佳化,過去需要大量工程師維護的軟體壁壘確實可能被削弱。
這對 AMD、Google TPU、AWS Trainium,甚至未來其他 AI 加速器都有利。晶片公司不一定需要自己完整複製 CUDA 十多年的軟體生態,只要 AI 能替開發者補掉一部分遷移成本,企業就更有理由採用多平台策略。
對一般讀者的影響
一般人不會直接接觸 GPU Kernel,但這種能力可能影響未來 AI 服務價格。
如果 AI 公司能在不同晶片平台之間更容易調度工作,就能根據價格、供應與效能選擇硬體,而不是只能依賴單一供應商。硬體競爭增加後,長期有機會降低部分 AI 運算成本。
不過,真正的大型部署仍涉及穩定性、叢集網路、軟體生態與長期維護,短期內不會因為三天移植案例就完全改變市場格局。
Meta Muse Ember 不追求最大,而是專門負責 Agent 每天做上千次的小工作
新聞重點
Meta Superintelligence Labs 最新推出 Muse Ember,定位為 Muse 系列目前最小、成本最低的模型,專門服務 Agent 高頻率重複執行的工作,包括工具呼叫、程式子任務、路由、資料擷取與長文件解析。(research.meta.ai:https://research.meta.ai/blog/muse-ember?utm_source=chatgpt.com)
Muse Ember 提供 100 萬 Token 上下文,支援文字、圖片、音訊與影片,而且可以直接處理螢幕截圖、掃描文件、會議錄音與影片,不需要為不同媒體另外切換模型。
Meta 把成本效益放在這款模型的核心。官方引用 Artificial Analysis 的結果表示,Muse Ember 在不同推理設定下位於目前「能力/單次任務成本」的效率前緣。正式 API 定價為每百萬輸入 Token 0.10 美元、每百萬輸出 Token 0.50 美元。(research.meta.ai:https://research.meta.ai/blog/muse-ember?utm_source=chatgpt.com)
Meta 也明確說明 Muse 系列的分工方式:Muse Wonder 負責最困難的規畫與推理,Muse Spark 偏向程式與 Agent 工作,而 Muse Ember 則負責大量、可重複的執行型任務。(research.meta.ai:https://research.meta.ai/blog/muse-ember?utm_source=chatgpt.com)
背景脈絡
Muse Ember 的定位很能說明 Agent 時代為什麼需要小模型。
一個客服 Agent 接到顧客問題後,可能先讀客戶資料、判斷問題類型、查詢訂單、整理退款規則,再把結果寫回 CRM。真正需要高階推理的部分只有少數幾步,大量工作其實只是按照規則執行。
如果公司一天處理十萬筆客服任務,模型每一次工具呼叫的成本都會被放大。
因此 Meta 想建立的並不是「一個 Muse 解決所有問題」,而是讓不同模型互相搭配。大模型負責思考,小模型負責大量執行,類似公司的主管與執行團隊。
知識點補充
這類架構可以稱為 Hierarchical Agent Architecture,階層式代理架構。
上層模型負責理解複雜目標與制定計畫,下層模型則依照計畫完成大量具體任務。如果途中遇到例外,再把問題升級回上層。
這種方式同時能控制成本與品質。因為真正昂貴的模型只在需要時出場,而不是每一次資料查詢都使用最高能力。
另一個重要指標是 Cost per Task,每項任務成本。對 Agent 服務而言,這往往比單純的每百萬 Token 價格更有意義。模型即使 Token 單價便宜,如果需要反覆嘗試十次才能完成任務,最終成本仍可能更高。
生活化說法
大型企業不會讓最資深的主管親自處理每張發票、每封客服信和每筆資料查詢。
主管負責制定原則、判斷例外,日常工作由其他人按照制度完成。
Meta Muse 的設計也開始有這種味道。Wonder 負責想清楚怎麼做,Ember 則負責把同一套規則穩定套用到大量日常工作。
我們的觀察
Muse Ember 透露出一個比 Benchmark 排名更重要的趨勢:AI 公司正在正式進入「模型組合管理」時代。
以前產品頁面只需要告訴使用者「這是我們最新、最強的模型」。現在 Meta、Google、OpenAI、Anthropic 都愈來愈需要提供不同價格、速度與能力的模型層級。
這背後的原因不是行銷,而是 Agent 讓模型使用量可能呈現數量級成長。聊天機器人一天回答二十次問題,和 Agent 一天在背景呼叫模型兩千次,是完全不同的成本結構。
因此未來模型公司的競爭優勢,可能不只是擁有一款冠軍模型,而是能不能建立一套自動調度架構,在使用者幾乎感覺不到的情況下,把每個任務分給成本最合理的模型。
對一般讀者的影響
未來使用 AI 時,畫面上可能只看到一個 Muse、Gemini 或 ChatGPT,但背後其實由多款模型輪流完成工作。
簡單任務交給便宜模型,可以讓訂閱額度更耐用;真正困難的問題再啟動高階模型,則能維持品質。
這代表「模型名稱」對一般使用者的重要性可能逐漸下降。真正重要的會變成整套服務能不能自動選對模型,把事情完成,而且價格合理。
我們的觀察
今天三則新聞都沒有在追求一句「最強模型」的結論,反而讓 AI 產業下一階段的樣子變得更清楚。
Google Hydrogen 處理的是速度與成本。它存在的理由不是擊敗 Gemini 4 Carbon,而是承擔 Carbon 根本不值得親自處理的大量工作。
Meta Muse Ember 則把這套邏輯直接產品化。Wonder 負責規畫,Ember 負責執行,同一個 Agent 背後開始形成真正的模型分工。
Anthropic 的 Mythos 又把分工往硬體層推進。AI 不只自己執行任務,甚至開始替 AI 公司處理跨 GPU 平台的底層工程,讓算力調度本身變得更有彈性。
這三條路線拼在一起,可以看到 AI 競爭的核心正在改變。
前沿能力仍然重要,因為沒有最強模型就很難突破新的任務邊界;但如果每一件事情都使用最強模型,成本又不可能支撐數十億人的全天候 Agent。
因此真正成熟的 AI 系統會愈來愈像企業組織,而不是單一超級員工。不同能力的模型負責不同工作,遇到複雜問題才逐級向上處理;底層算力也不一定永遠固定在同一家晶片,而是根據成本與供應條件調度。
前幾年 AI 公司最喜歡證明「我的模型什麼都會」。
接下來更重要的能力,可能是知道什麼事情根本不需要派最強的模型去做。
當模型從產品變成一整支團隊,AI 真正的成本競爭才剛開始。
資料來源
- Business Insider|Google is letting staff test a “fast” new Gemini AI model named Hydrogen
- Yahoo 財經|Google 內部測試高速 AI 模型 Hydrogen
- https://tw.stock.yahoo.com/news/%E8%B0%B7%E6%AD%8C%E5%85%A7%E9%83%A8%E6%B8%AC%E8%A9%A6%E9%AB%98%E9%80%9Fai%E6%A8%A1%E5%9E%8Bhydrogen-%E5%82%B3%E5%B0%88%E7%82%BA%E6%95%88%E7%8E%87%E8%88%87%E9%80%9F%E5%BA%A6%E8%A8%AD%E8%A8%88-224551504.html
- Anthropic|Claude Fable 5.2 and Mythos 5.2
- Anthropic|IPO Roadshow / S-1 公開資料
- SEC|Anthropic S-1/A
- ETtoday AI|Claude Mythos 協助 AMD GPU 移植
- https://ai.ettoday.net/news/3270665
- Meta Superintelligence Labs|Introducing Our Smallest, Most Efficient Model: Muse Ember
- TechCrunch|Meta releases Muse Ember, a lightweight model for agent execution
- 科技新報|Meta 推出 Muse Ember
- https://technews.tw/2026/11/11/muse-introduces-muse-ember/
延伸閱讀
作者:NineLife AI 編輯室
最後更新:2026年11月12日
本文由 NineLife AI 編輯室整理公開資料後撰寫,可能使用 AI 工具協助草稿整理;發布前會人工檢查來源、事實與語意。內容僅供資訊參考,不構成法律、投資、醫療、稅務或其他專業建議。
留言
張貼留言
留言會先經過審核。歡迎補充觀點或來源;請勿張貼廣告、無關連結、成人、賭博、藥品或自動產生的內容。