Google 淘汰 Gems、企業 AI 規範進法院
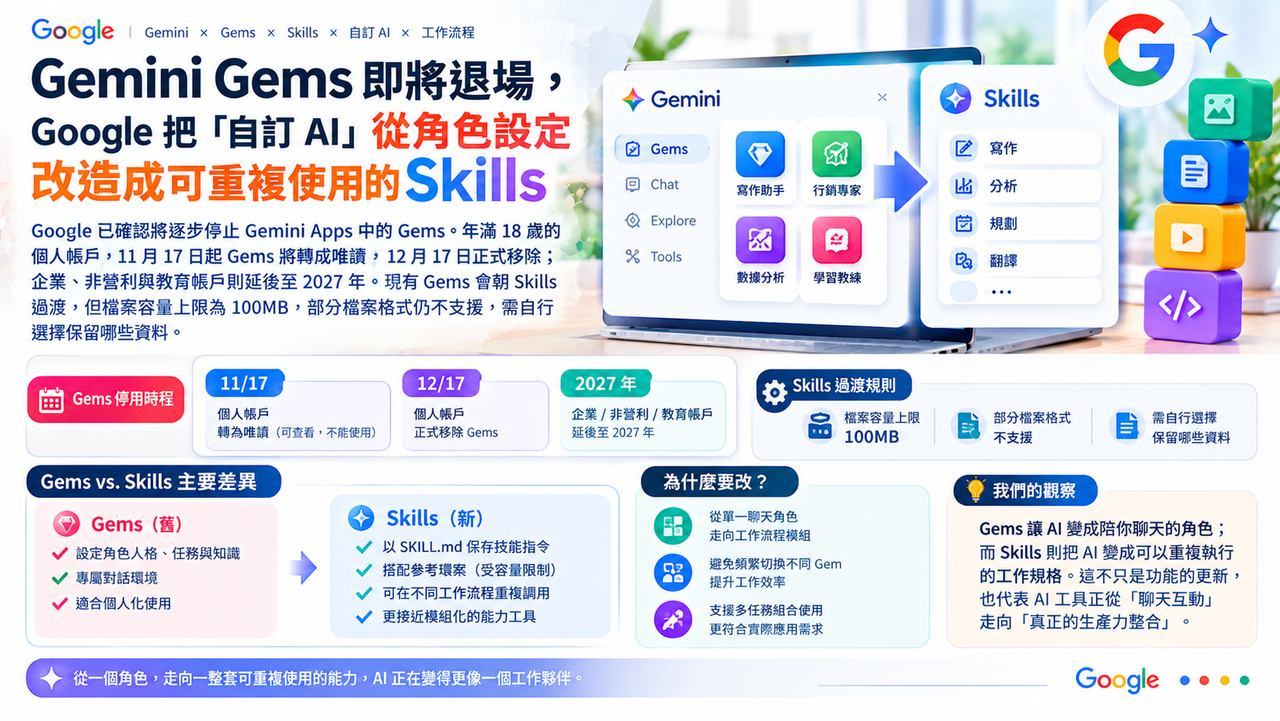
Gemini Gems 即將退場,Google 把「自訂 AI」從角色設定改造成可重複使用的 Skills
新聞重點
Google 已確認將逐步停止 Gemini Apps 中的 Gems。年滿 18 歲的個人 Google 帳戶,11 月 17 日起 Gems 將轉成唯讀,使用者仍可查看內容,但不能再使用、編輯或新增;到了 12 月 17 日,Gems 將正式從 Gemini Apps 移除。企業、非營利與教育帳戶則採較晚的過渡時程,分別延續至 2027 年。
現有 Gems 會朝 Skills 過渡,但不代表所有附件都能原封不動搬家。Google 官方規定,一個 Skill 的檔案總容量上限為 100MB,若原有內容超過限制,使用者需要自行選擇保留哪些資料;部分舊版 Office、音訊、影片、壓縮檔與特定程式格式目前也不支援。
Skills 的核心格式是一個位於專案根目錄的 SKILL.md,裡面保存技能名稱與操作指令,再搭配必要的參考檔案。和 Gems 最大的使用差異,是它不再只像一個需要另外開啟的「自訂聊天角色」,而比較接近可以被不同工作流程重複調用的能力模組。
背景脈絡
Gems 出現時,生成式 AI 的使用方式仍然很接近聊天機器人。使用者會替一個 Gem 設定人格、任務與知識,再進入那個專屬對話環境使用。
Agent 與 Skills 普及後,這種架構開始顯得比較受限。使用者可能同時需要研究資料、校正文案、套用品牌寫作規則與整理表格,如果每種能力都必須切換到不同 Gem,工作本身就會被「聊天視窗」切碎。
Skills 的設計方向比較接近軟體模組化。與其建立一百個不同 AI 角色,不如把「寫新聞」、「審核文案」、「整理會議」等能力各自保存,需要時再組合使用。
這也是 AI 工具正在從「陪你聊天的角色」走向「可重複執行的工作規格」的一個明顯訊號。
知識點補充
SKILL.md 可以把它理解成一份給 AI 閱讀的標準作業說明。
裡面不一定需要放程式,而可以明確描述這項技能負責什麼、應遵守哪些規則、輸入資料如何處理,以及成果應該用什麼格式輸出。
它的價值在於 Portability,可移植性。如果工作規則只藏在某個聊天機器人的後台設定裡,離開那個產品後就很難繼續使用;以文件形式保存後,就比較容易備份、版本管理與搬移。
不過,標準化並不代表自動轉移一定完整。尤其 Gems 中如果累積大量附件,Google 這次的容量與格式限制就很重要,使用者仍需要自己確認真正重要的資料是否留下。
生活化說法
Gems 比較像公司裡一位「固定職務的專員」。要處理不同事情,就分別去找不同的人。
Skills 則比較像一套整理好的 SOP。需要做企畫時拿企畫 SOP,需要翻譯時再加上翻譯 SOP,同一個工作者可以依任務把幾套規則組合起來。
兩種方式都能完成工作,但後者更適合需要反覆組合不同能力的流程。
我們的觀察
Google 淘汰 Gems 並不代表自訂 AI 失敗,反而比較像產品形態正在改變。
當模型愈來愈能自動判斷應該使用哪個工具,「先選一個 AI 角色再開始聊天」可能逐漸變成多餘步驟。真正有價值的東西,會從角色名稱與人設,轉向背後累積的工作方法、參考資料與輸出規則。
這也讓 Skills 類標準可能成為新的競爭點。企業未來真正想保存的,不一定是某一段 Prompt,而是整套工作方法。如果技能能用標準文件保存,就比較不容易完全被綁在單一 AI 平台。
對一般讀者的影響
如果過去建立過重要 Gems,現在最實際的事情不是等 Google 自動搬完,而是先檢查自訂指令與知識附件。
尤其有大量 PDF、Office 文件或其他素材的使用者,應確認 100MB 限制與支援格式,重要資料最好自行保存。AI 工具的功能可以更換,但自己花時間整理出的工作規則與知識庫,不應只存在單一平台裡。
員工把公司資料交給 AI 做 PPT 遭解僱,法院卻認定企業自己沒先把規則寫清楚
新聞重點
北京市朝陽區人民法院近期公布一起與生成式 AI 辦公有關的勞動案件。一名任職保險公司的法務人員,2024 年為提高簡報與資料分析效率,把自行整理過的公司稽核問題資料上傳至第三方 AI 平台。
公司認為,員工曾簽署保密協議,也接受資訊安全訓練,將公司資料交給第三方平台可能造成資料留存、模型訓練或其他外洩風險,因此以嚴重違反公司制度為由解除勞動契約。
法院最後沒有認同這項解僱。判決重點並不是認為「公司資料可以隨便交給 AI」,而是公司當時沒有制定明確的第三方 AI 使用規則,也沒有證明相關資料屬於必須嚴格保密的核心資訊,更無法證明實際造成資料外洩或經濟損害。
法院最終認定單方面解僱違法,要求恢復勞動關係,並補發薪資、獎金與績效差額等合計人民幣 4.6 萬餘元。二審維持原判,目前判決已生效。
背景脈絡
這類爭議未來很可能愈來愈常見,因為很多公司正處於一個尷尬階段:管理層鼓勵員工使用 AI 提升效率,但資訊安全規章仍然停留在「禁止把公司資料傳到私人信箱、USB 或雲端硬碟」的年代。
對員工來說,ChatGPT、Claude 或其他第三方 AI 看起來只是一個新的辦公工具;對資訊安全部門來說,只要把公司內容輸入外部服務,就已經涉及資料離開企業控制範圍。
如果企業只有口頭要求大家「多用 AI」,卻沒有清楚說明哪些平台能用、哪些資料不能輸入、是否需要匿名化,以及誰負責審核,出事時就很難只把所有責任推給員工。
知識點補充
企業 AI 治理裡很重要的一個概念是 Data Classification,資料分級。
不是所有公司資料都屬於同樣風險。有些是公開資料,有些只是一般內部資訊,另外還可能包含客戶個資、合約、財務資訊、尚未發布產品與真正的商業機密。
企業比較成熟的做法,是先把資料分級,再規定不同等級能不能進入公共 AI、企業版 AI,或者只能留在內部系統處理。
另一個重要問題是模型服務本身的資料政策。不同免費版、企業版、API 的資料保存與訓練條款可能不同,因此「使用 AI」並不是一個足夠精確的資訊安全分類。
生活化說法
公司如果只告訴員工「你可以開車出去辦公」,卻沒有說哪些車可以開、公司的文件能不能放車上,也沒有規定鑰匙怎麼保管,最後不能等東西出了問題才突然宣布某個行為早就屬於重大違規。
AI 辦公也是同樣道理。
企業可以要求員工負保密責任,但如果希望 AI 成為正式工作工具,就需要把允許範圍與禁止事項說清楚,而不是等事件發生才補規則。
我們的觀察
這個案件真正有代表性的地方,是它把 AI 治理從「資訊部門的建議」帶進了真正的勞動關係。
很多企業目前會發布一封 Email,提醒大家不要把機密資料貼進 ChatGPT,卻沒有進一步建立可以實際執行的分類、教育與替代工具。這種模糊狀態,在使用人數少時還能靠提醒維持,AI 一旦變成日常辦公工具就很難持續。
企業真正需要的不是一句「禁止使用外部 AI」,而是一套讓員工知道什麼可以做、什麼不能做,而且仍然能保留 AI 生產力的制度。否則規定愈模糊,最後衝突往往發生在人資處分,而不是資訊安全改善。
對一般讀者的影響
在公司沒有明確 AI 規範的情況下,也不代表員工可以任意上傳內部資料。比較安全的原則,是涉及客戶個資、合約、內部營運數據、財務資訊或未公開內容時,不要直接送進自己無法確認資料政策的第三方 AI。
而對主管來說,如果真的希望團隊大量使用 AI,第一件事也不應只是買帳號,而是先把資料分級與工具清單訂出來。
美國期中選舉過後,AI 不只是一項科技政策,資料中心已經直接出現在選票上
新聞重點
2026 年美國期中選舉讓 AI 產業第一次如此明顯地進入地方選票、國會控制權與政治資金討論。
截至目前,CBS News 已預測民主黨將在新一屆國會取得眾議院與參議院控制權。這是媒體依已開出票數與選舉模型做出的選舉預測;個別席次仍需要依各州正式認證程序確認。
對 AI 產業更直接的變化則出現在地方。俄亥俄州共有 18 個地方行政區處理 21 項與資料中心相關的公投,初步結果顯示,至少 14 個地區通過禁令、開發限制或其他管制。特倫頓一項資料中心禁令更以約 80% 支持通過。全美此次共有 41 項資料中心相關地方公投,顯示大型 AI 基建已從招商議題正式進入地方民主程序。
這波選舉同時伴隨大量 AI 產業政治資金。Fortune 引述 Tech Influence Watch 統計指出,2026 選舉週期內,AI 相關超級政治行動委員會在 68 個眾議院及參議院席次投入約 7,900 萬美元。不同團體的政策立場並不一致,一方傾向降低州級 AI 管制、建立全國統一規則,另一方則支持較強的 AI 安全護欄。
背景脈絡
美國 AI 政策過去主要集中在華盛頓,包括晶片出口、模型安全與聯邦監管。但資料中心帶來的問題非常地方化,因為真正承受電網、土地、水資源與噪音影響的是城市與社區。
這也讓 AI 治理出現兩條不同路線。聯邦政府希望建立全國政策,避免五十個州出現互不相同的規則;地方政府與州政府則認為,資料中心是否能蓋、居民是否需要承擔電網升級成本,本來就是地方治理範圍。
2025 年,美國參議院曾以 99 比 1 的壓倒性表決刪除一項限制各州在十年間制定 AI 法規的提案,已經顯示國會對完全凍結州級 AI 監管缺乏支持。選後政治版圖改變,也意味著未來聯邦與州之間誰擁有多少 AI 規範權,仍會持續爭論。
知識點補充
這裡最重要的法律概念是 Preemption,聯邦先占。
美國同時存在聯邦法與州法。如果國會制定一套全國 AI 法規,並明確規定同一領域由聯邦規則優先,就可能限制各州自行制定不同標準。
支持全國統一規則的人認為,如果每州要求都不同,企業很難開發同一套 AI 產品;反對過度先占的人則認為,各州應保有處理消費者、兒童、隱私與地方基礎建設問題的權力。
資料中心公投又是更地方的一層。它不是在決定「美國要不要發展 AI」,而是決定某個城市願不願意接受特定規模的資料中心,以及業者需要遵守哪些土地、能源與稅務條件。
生活化說法
一家公司要在全美開連鎖店,當然希望五十個州的規則愈一致愈方便。
但如果其中一家大型分店要蓋在某個小鎮旁邊,每天使用大量水電,當地居民自然也會認為自己應該有發言權。
現在美國 AI 政策碰到的就是這種上下層問題。科技公司希望有統一規則,但地方居民關心的卻是眼前那一座資料中心會不會影響自己的生活成本。
我們的觀察
2026 年選舉最值得 AI 產業注意的,不只是國會哪個政黨取得多數,而是 AI 已經從華盛頓的產業政策變成地方選民能直接投票的生活議題。
電價、土地、水資源與資料中心,對一般選民而言比模型 Benchmark 更具體。當 AI 基建開始影響帳單與社區環境,科技公司就不能只用「維持美國 AI 領先」作為完整說明,也需要向地方解釋利益如何分配、基建成本由誰承擔。
另一個變化則是 AI 產業的政治參與已經制度化。支持寬鬆監管與支持較強安全規則的科技資金都開始進入選舉,甚至可能支持不同政黨的候選人。這代表未來的 AI 政治不會單純按照民主黨或共和黨分線,而可能更多圍繞資料中心、州權、模型安全、出口管制與市場競爭形成新的聯盟。
對一般讀者的影響
美國選舉不會在隔天立即重寫所有 AI 法律。新一屆國會要到 2027 年 1 月才正式開始運作,新的聯邦法案仍需經過眾議院、參議院與總統程序。
但地方公投的效果更直接,各地通過的限制可以較快影響當地資料中心計畫。因此未來 AI 基建的發展速度,可能愈來愈不是由科技公司單方面決定,而要經過地方政府、電力公司與選民共同協商。
我們的觀察
今天三則新聞看起來分屬產品、職場與政治,其實都在處理同一個問題:AI 普及之後,原本模糊的規則開始不夠用了。
Google 從 Gems 轉向 Skills,是產品架構先發生改變。AI 不再只是建立一個個不同角色,而是需要把工作規則保存成可以移植、組合與重複執行的標準模組。
北京的勞動案件則顯示企業制度落後了一步。公司希望享受 AI 帶來的效率,卻沒有同步告訴員工什麼資料可以輸入、什麼平台可以使用。當規定停留在舊時代,最後連法院都必須協助界定責任。
美國期中選舉把這個問題放大到整個社會。AI 資料中心需要土地、電力與資金,但地方居民也要求參與決定;科技公司希望全國規則一致,各州又不願完全交出監管權。
AI 技術真正開始成熟時,最大的摩擦往往不是模型不夠聰明,而是舊制度不知道該怎麼容納它。
因此接下來幾年,AI 產業很可能會同時出現兩種速度。模型能力仍然快速前進,但企業內規、勞動制度、地方政府與聯邦法律會花更長時間追上。
這不一定代表監管拖累創新,而是任何真正進入社會的大型技術,都必須從「可以使用」走到「知道怎麼使用」。
AI 普及的下一階段,競爭的不只是誰先做出功能,而是誰能先把規則寫清楚。
資料來源
- Google Gemini Apps Help|Gems transition to skills
- Google:Gems 轉換至 Skills 官方說明
- Google Gemini Apps Help|Create & manage skills for Gemini Apps
- Google:Gemini Skills 建立、SKILL.md 與檔案規格
- ETtoday AI|Gemini Gems 停用與 Skills 過渡
- 原始新聞
- 北京日報/北京市朝陽區人民法院|使用第三方 AI 處理公司文件勞動案件
- 北京日報案件報導
- ETtoday AI|員工用 AI 製作簡報遭解僱案
- 原始新聞
- CBS News|2026 美國期中選舉眾議院與參議院控制權
- CBS News 選舉結果與預測更新
- Fortune|俄亥俄州資料中心公投與地方限制
- Fortune:Ohio data center ballot measures
- Fortune|2026 AI Super PAC 選舉支出
- Fortune:AI super PACs in 2026 midterms
- AI 郵報|2026 美國期中選舉與 AI 產業整理
- AI 郵報原文
延伸閱讀
作者:NineLife AI 編輯室
最後更新:2026年11月7日
本文由 NineLife AI 編輯室整理公開資料後撰寫,可能使用 AI 工具協助草稿整理;發布前會人工檢查來源、事實與語意。內容僅供資訊參考,不構成法律、投資、醫療、稅務或其他專業建議。
留言
張貼留言
留言會先經過審核。歡迎補充觀點或來源;請勿張貼廣告、無關連結、成人、賭博、藥品或自動產生的內容。