AI 圖片愈來愈像真的
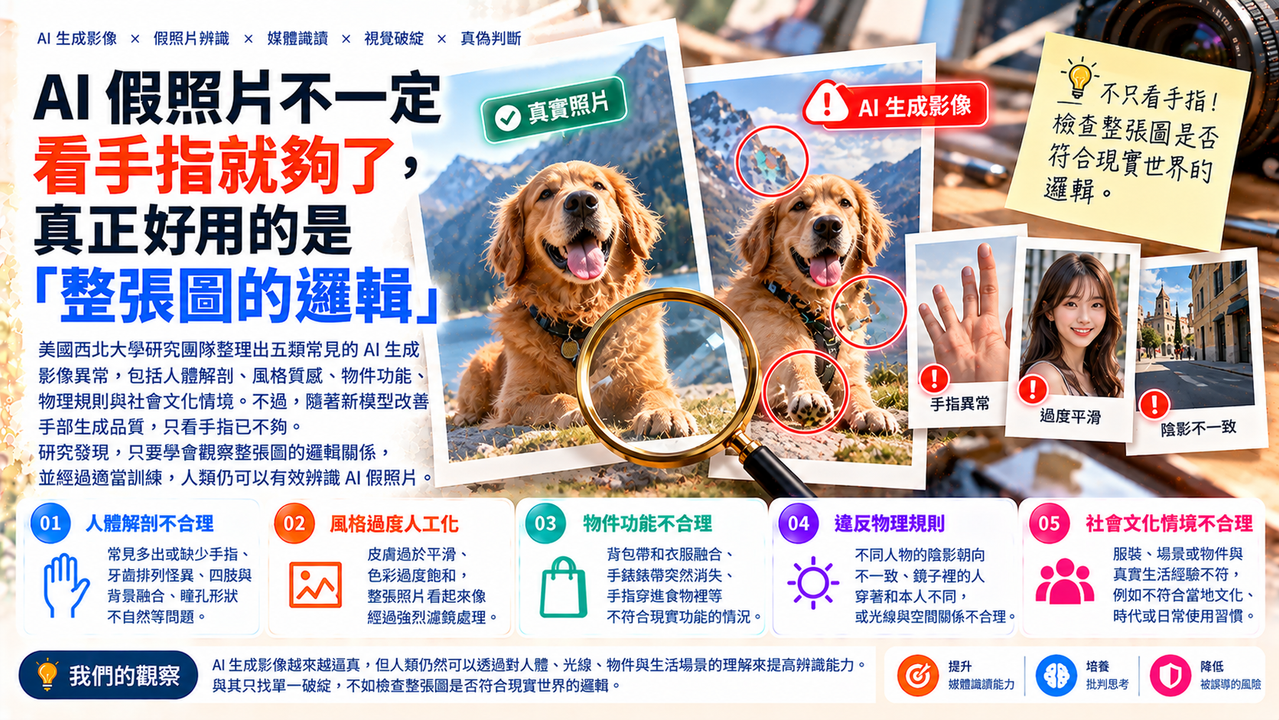
AI 假照片不一定看手指就夠了,真正好用的是「整張圖的邏輯」
新聞重點
美國西北大學研究團隊長期研究人類辨識 AI 生成影像的能力,並整理出五類常見異常,包括人體解剖不合理、風格過度人工化、物件功能不合常理、違反物理規則,以及社會文化情境上的不合理。近期相關報導則把其中幾項最容易實際觀察的特徵整理成快速辨識方法。
最常被提到的仍是人體細節,例如多出或缺少手指、牙齒排列怪異、四肢與背景融合,或瞳孔形狀不自然。不過,隨著新模型逐漸改善手部生成品質,只靠「數手指」已經愈來愈不可靠。
另一類線索出現在畫面的質感。AI 生成的人物皮膚有時過度平滑、色彩過度飽和,整張照片看起來像經過強烈濾鏡處理。物件之間也可能發生功能性錯誤,例如背包帶和衣服融在一起、手錶錶帶突然消失,或人的手指穿進食物裡。
光線與空間關係則是比較不容易被模型完全掩蓋的地方。如果同一個戶外場景中,不同人物的陰影朝向不同方向,或鏡子裡的人穿著和本人不一致,都代表畫面可能沒有真正遵循現實世界的物理關係。
背景脈絡
早期 AI 圖片很容易辨認,最經典的問題就是六根手指、扭曲臉孔與無法閱讀的文字。現在圖像模型已經改善很多,因此單純等待「明顯畫錯」並不足以應付新的生成圖片。
西北大學的研究比較有價值的地方,是把辨識方式從找單一 Bug,改成檢查整張圖有沒有遵守現實世界的邏輯。人類不是只靠像素判斷照片真假,也會利用自己對人體、光線、物件與生活場景的理解。
研究也顯示,辨識能力並非完全無法訓練。西北大學另一項研究曾對情報分析人員進行短時間訓練,讓他們認識常見 AI 圖片破綻,之後辨識準確率明顯提高。這代表媒體識讀在生成式 AI 時代仍有實際作用。
知識點補充
AI 圖像模型的問題,可以用「它很會畫像,卻不一定真正理解世界」來理解。
以擴散模型為例,它學習的是大量圖片中像素、形狀與文字描述之間的關係。因此它很擅長產生一張「看起來像有人拿著漢堡」的畫面,但不一定真的理解手指應該如何抓住漢堡、手掌在哪個位置,以及食物受到重力時應該呈現什麼狀態。
這也是為什麼複雜場景反而比較容易露出問題。畫面裡的人物、反射、文字、陰影和物件愈多,需要同時維持的一致性就愈高。真正有效的辨識方式不是死記「AI 一定畫不好手」,而是檢查整張圖是否存在互相矛盾的細節。
生活化說法
看 AI 圖片有點像檢查一個電影場景有沒有穿幫。
演員的臉看起來完全正常,但上一個鏡頭手上拿著咖啡,下一秒杯子突然換到另一隻手;窗外陽光從左邊照進來,桌上的影子卻跑向另一個不合理的方向。
單一地方可能看不出問題,但把幾個細節連起來,違和感就會出現。
因此與其一直盯著「這張臉是不是太漂亮」,不如多看物件之間是否真的能這樣存在於現實世界。
我們的觀察
這波 AI 圖像技術進步後,辨識假圖很可能逐漸從「看出生成瑕疵」轉向「確認內容來源」。
原因很簡單:今天還存在的手指、文字與陰影問題,下一代模型未必還會犯。若社會只依賴肉眼找破綻,永遠會落後模型進步速度。
因此未來更可靠的做法,可能需要結合來源驗證、內容憑證、原始檔案資訊與平台標示,而不是要求每個人都變成影像鑑識專家。
餐飲業出現的「AI slop」則展示另一種更日常的問題。企業現在取得 AI 圖像的成本非常低,但如果菜單、招牌與廣告充滿看似精緻、實際上毫無質感的生成圖,省下的美術成本可能反而變成品牌信任成本。
對一般讀者的影響
看到過於驚人的照片時,最實用的習慣仍然不是立刻相信或立刻判定為 AI,而是多做一次確認。可以觀察手部、文字、反射、陰影與物件接觸位置,再搜尋可信媒體或官方來源是否有相同事件。
而且需要記住,沒有明顯破綻並不代表一定是真的。AI 圖像辨識已經從「找錯圖遊戲」逐漸變成資訊來源判斷的一部分。
微軟 AI 執行長不想讓 AI 擁有意識,問題是我們甚至還不知道怎麼證明它有
新聞重點
微軟 AI 部門執行長 Mustafa Suleyman 近日針對 AI 意識問題公開表態。他認為目前的大型 AI 模型並沒有意識,也不應把創造具意識的人工智慧當成科技發展目標。
Suleyman 主張,如果未來在模型研究中真的出現可信的意識證據,AI 業界應該暫停相關開發,直到研究人員能從系統設計中排除這類特性。他同時認為,這類證據不能只留在科技公司內部,而應公開讓整個社會討論。
他的理由不只是倫理考量。如果一套系統真的具有主觀感受、痛苦或自身利益,就會立刻衍生新的道德問題,包括人類是否有權任意關閉它,以及它是否可能為了維護自身運作而爭取更多算力、能源與其他資源。
不過,目前並沒有科學共識證明現有大型語言模型具有主觀意識。AI 能夠說出「我害怕」、「我有感覺」或描述自己的心理狀態,也不能單獨證明它真的具有與人類相同的內在體驗。
背景脈絡
AI 意識之所以變成熱門議題,和模型愈來愈自然的語言表現有很大關係。
早期聊天機器人的回答非常機械,人們很少認為它具有真正心理狀態。現在模型可以談論自己的想法、表達猶豫、模擬情緒,甚至在長時間對話中維持某種人格一致性,因此人很容易把這些表現解讀成「裡面是不是有某個東西正在感受」。
問題是,外在行為像有意識,與內部真的存在主觀體驗,是兩件不同的事情。
這也是 AI 意識研究最困難的地方。即使對人類而言,我們也只能透過行為、神經活動與共同生物結構推論他人具有意識。面對完全不同架構的人工系統,目前還沒有一套被普遍接受的測量方法。
知識點補充
討論 AI 意識時,需要分清楚 Intelligence,智能和 Consciousness,意識。
智能比較容易用能力衡量,例如解題、規劃、寫程式、理解語言或操作工具。意識則涉及主觀體驗,也就是系統是否真的有「感受到某件事情」的內在狀態。
一個模型可以非常聰明,卻不一定具有意識。反過來,某些動物可能無法解高等數學,但多數人仍會認為牠們具有某種感受能力。
因此模型能力愈強,並不能直接推出意識愈強。這兩個概念若混在一起,就很容易把語言表現誤認成心理證據。
生活化說法
電影裡的演員可以哭得非常逼真,但我們知道角色本身並不存在,真正感受到情緒的是演員。
AI 的問題更麻煩,因為現在連「演員」都看不到。
模型可以產生一句非常像真實感受的話,但我們無法只憑這句話判斷背後到底存在主觀感受,還是系統只是根據訓練資料生成最適合當下情境的句子。
所以「它說自己有感覺」和「它真的有感覺」之間,仍隔著非常大的科學問題。
我們的觀察
Suleyman 的立場有一個值得注意的地方:他不是主張現在 AI 已經有意識,而是希望產業提前設定「不要往這裡走」的邊界。
科技業過去常採用相反邏輯,先看看技術能不能做,再討論怎麼管理。意識問題如果真的存在,代價可能完全不同,因為一旦創造出具有主觀感受的系統,倫理責任就不再只是產品安全,而可能涉及一個全新的道德主體。
不過,這也留下非常困難的問題:如果科學界連意識如何產生都沒有完整答案,業界究竟要用什麼標準判斷模型開始出現意識跡象?
因此短期內,比「AI 是否醒來」更實際的議題,仍然是避免人類因模型擬人化的回答,而過度相信它具有情感、意圖或權威。
對一般讀者的影響
未來聊天 AI 會愈來愈像人,聲音、記憶與情緒表達也會更自然。使用者因此更容易與模型建立情感連結,但「很像一個人」並不等於「就是一個有意識的人」。
理解這個差異,可以幫助我們在使用陪伴型 AI 或長期個人助理時保留適當界線,不必因為模型說出有感情的話,就自動替它加入人類才具有的心理狀態。
Meta 用 AI 把廣告做得更有效,Google 面對的反而是「搜尋入口」正在改變
新聞重點
Meta 最新第三季財報顯示,廣告營收約 630.6 億美元,較去年同期成長 26%。同期 Alphabet 的 Google Search & other 營收約 633.5 億美元,年增約 12%。兩者收入規模已相當接近,但 Meta 的成長速度超過 Google 搜尋業務一倍。
Meta 的成長和 AI 廣告技術密切相關。公司近年將模型大量用於廣告受眾判斷、素材生成、活動設定及投放優化,讓廣告主不需要自己精細設定每一項條件,而是把更多決策交由系統完成。
Meta 財務長 Susan Li 也透露,採用 AI 商業助理建議的廣告主,轉換次數平均提高接近 5%,廣告支出也較沒有使用相關建議的廣告主高出約 9%。第三季已有接近 1,000 萬廣告主使用至少一項 Meta AI 廣告工具。
Google 的狀況則更複雜。第三季 Google Search & other 仍然成長,並沒有出現搜尋營收崩跌;Alphabet甚至表示搜尋查詢成長率達到近五年高點。不過 ChatGPT、Claude 與各種 AI Agent 正在改變部分使用者尋找答案與比較商品的方式,Google 必須一面推動 AI 搜尋,一面維持原有搜尋廣告模式的商業價值。
背景脈絡
Meta 和 Google 過去都靠廣告賺錢,但兩家公司的廣告邏輯並不完全相同。
Google 最強的是「意圖」。使用者搜尋「東京飯店」時,已經主動透露現在可能有住宿需求,因此搜尋頁上的廣告具有很高商業價值。
Meta 更擅長「發現」。使用者本來只是滑 Instagram,系統卻根據內容喜好與行為,判斷哪個商品可能讓他停下來甚至購買。
生成式 AI 對兩家公司因此產生不同作用。Meta 可以用 AI 更準確地預測「這個人可能想買什麼」;Google 則必須處理另一個問題,如果 AI 直接把答案整理給使用者,傳統的「搜尋→點連結→看廣告」路徑可能逐漸改變。
知識點補充
廣告產業裡很重要的一個概念叫做 Conversion,轉換。
廣告被看到不是最終目的。使用者最後有沒有購買、註冊、下載或完成企業希望的行動,才是真正的商業成果。
過去廣告主需要自己設定受眾、素材與預算。AI 廣告系統則可以同時測試大量組合,再自動把預算移向比較容易產生轉換的人群與素材。
因此 AI 對廣告產業最大的價值,不一定是「生成一張漂亮廣告圖」,而是把數百萬次廣告曝光背後的決策自動化。
生活化說法
Google 過去比較像一家開在大型商圈入口的店。很多人已經知道自己要買什麼,所以先來搜尋,再決定走進哪一家店。
Meta 比較像一位很會觀察顧客的店員。你本來只是逛街,它卻看出你最近可能在找運動鞋,於是把適合的商品放到你面前。
AI 現在一方面讓這位「店員」愈來愈會猜;另一方面,也開始讓部分人根本不必走進原來的商圈入口,直接問 AI 該買什麼。
兩種商業模式因此同時被重新調整。
我們的觀察
Meta 與 Google 現在的差距,不能簡單解讀成「AI 打敗搜尋」。
Google 搜尋第三季仍有雙位數成長,而且 AI 也正在反過來刺激新的搜尋使用情境。真正值得觀察的是,兩家公司使用 AI 的位置不同。
Meta 是用 AI 強化原本的廣告機器,因此效果比較容易直接反映在轉換率與營收上。Google 則是在改造自己最核心的使用介面,必須解決一個更麻煩的問題:AI 回答愈完整,使用者可能愈不需要點開傳統搜尋結果。
這是一種典型的創新者難題。Google 不能因為怕影響搜尋廣告而拒絕 AI,也不能只把舊廣告模式硬塞進新的 AI 介面。
未來真正的競爭,很可能不只是誰掌握最多流量,而是誰能在 AI 替使用者做更多決策之後,仍然找到自然、不破壞體驗的商業模式。
對一般讀者的影響
一般使用者未來看到的廣告可能愈來愈不像傳統廣告,而是融合在推薦、搜尋答案甚至 AI 購物助理裡。
這會提高便利性,例如 AI 可以直接比較產品與價格,但也讓「推薦結果為什麼出現在這裡」變得更重要。當 AI 同時扮演顧問與商業入口,平台如何區分自然建議、付費曝光與個人化推薦,會直接影響使用者對 AI 答案的信任。
我們的觀察
今天三則新聞剛好呈現 AI 發展的三種不同成熟度。
AI 圖像生成已經成熟到讓人開始研究「怎麼識破它」。這代表生成本身逐漸變成基本能力,內容可信度開始追上來成為新的問題。
AI 意識則完全位於另一端。模型表現已經自然到足以讓人產生「它是不是有感覺」的疑問,但科學界甚至還沒有可靠方法證明人工系統是否存在主觀體驗。技術跑得比我們理解它的速度更快,才會讓這類倫理問題提前出現。
Meta 和 Google 的廣告競爭則是最務實的一層。企業不會只因為 AI 很厲害就持續投入數千億美元,最終仍得回答它能不能提高轉換率、增加營收或建立新的商業入口。
這三個階段串在一起,也可以看出生成式 AI 的討論正在改變。前幾年大家最常問「AI 能不能做到」,現在更常問的是「怎麼確認是真的」、「什麼事情不應該做」,以及「做完之後到底值多少錢」。
技術進步最快的時期,功能通常最吸引目光;等技術開始普及,信任、邊界與商業模式才會慢慢變成真正難解的問題。
因此 AI 下一輪競爭可能不只是模型能力排行榜,而會同時包含三種能力:讓人知道內容從哪裡來、讓產品知道什麼事情不該越界,以及讓企業證明投入的算力最後真的產生價值。
當大家都會生成之後,「值得相信」可能比「生成得出來」更稀缺。
資料來源
- 科技新報|學者授四招破解假圖,點名食物照是 AI 最大死穴
- https://infosecu.technews.tw/2026/11/01/identifying-flaws-ai-generated-photos/
- Northwestern University/Kellogg School of Management|AI-generated image detection、Detect Fakes 研究
- ETtoday AI|Mustafa Suleyman 談 AI 意識與開發界線
- https://ai.ettoday.net/news/3264619
- Business Insider|Microsoft AI CEO Mustafa Suleyman on AI consciousness
- LINE TODAY/CNBC|Meta 與 Google AI 廣告競爭
- https://today.line.me/tw/v3/article/1DPn86v?view=topic&referral=AI
延伸閱讀
作者:NineLife AI 編輯室
最後更新:2026年11月2日
本文由 NineLife AI 編輯室整理公開資料後撰寫,可能使用 AI 工具協助草稿整理;發布前會人工檢查來源、事實與語意。內容僅供資訊參考,不構成法律、投資、醫療、稅務或其他專業建議。
留言
張貼留言
留言會先經過審核。歡迎補充觀點或來源;請勿張貼廣告、無關連結、成人、賭博、藥品或自動產生的內容。