Meta 新模型 Muse Wonder 亮相
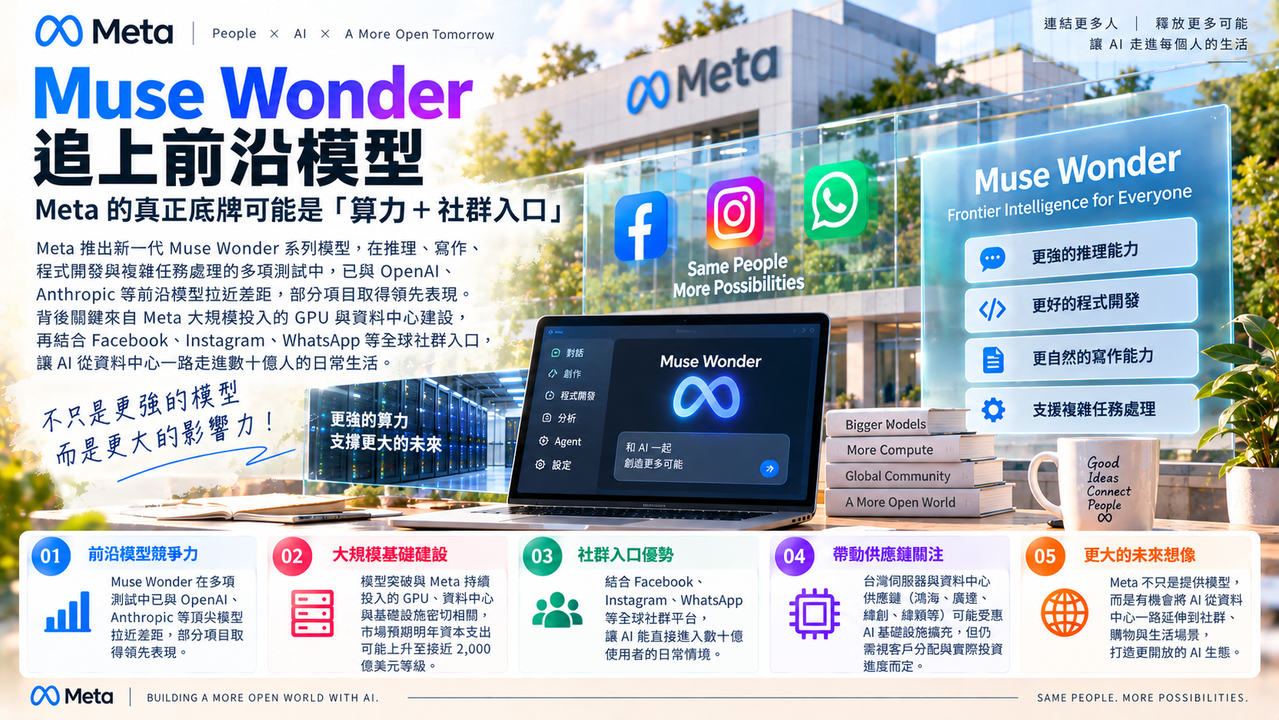
Muse Wonder 追上前沿模型,Meta 的真正底牌可能是「算力+社群入口」
新聞重點
Meta 推出新一代 Muse Wonder 系列模型,定位明顯瞄準目前最強的一線 AI 模型,主打推理、寫作、程式開發與複雜任務處理。
依 Meta 公開說法,Muse Wonder 在部分測試中已經能和 OpenAI、Anthropic 等競爭對手拉近差距,部分項目甚至取得領先表現。不過,不同 Benchmark 的測試條件與評估方式並不完全相同,因此更適合把結果理解為「Meta 已進入前沿模型競爭區」,而不是簡化成全面超越所有對手。
祖克柏格也強調,這次模型突破與 Meta 大規模投入 GPU、資料中心與基礎建設密切相關。市場目前關注 Meta 明年的資本支出可能進一步上升至接近 2,000 億美元等級,但實際金額仍應以公司正式財測與公告為準。
台灣市場同時關注伺服器與資料中心供應鏈,包括鴻海、廣達、緯創、緯穎等業者是否會因大型雲端業者持續擴充 AI 基礎設施而增加訂單。不過,供應鏈「可能受惠」屬產業推估,仍會受到客戶分配、產品組合與實際投資進度影響。
背景脈絡
Meta 過去在 AI 市場有一個很特別的位置。
它不缺使用者。
Facebook、Instagram、WhatsApp 本來就掌握全球龐大的社群入口。
真正的問題是,在最高階模型競爭中,市場長期更常把 OpenAI、Google 與 Anthropic 放在第一排。
Muse Wonder 的意義,就是讓 Meta 嘗試補上這一塊。
一旦模型能力、算力、社群平台與個人 AI Agent 都掌握在同一家公司手上,Meta 就不只是提供模型,而是能把 AI 從資料中心一路送到一般人的社群、購物與日常使用情境。
知識點補充
這則新聞最重要的概念之一,是 AI 資本支出(AI Capex)。
Capex 指的是資本支出,也就是公司用來蓋資料中心、買伺服器、GPU、網路設備與電力設施的長期投資。
大型 AI 模型要持續進步,不只是研究人員寫出更好的演算法而已。
背後還需要:
更多高階晶片。
更大的資料中心。
更快的網路。
更多電力與散熱設備。
所以現在 AI 模型競爭,某種程度也是「誰能長期負擔巨額基礎建設」的競爭。
生活化說法
可以把 AI 模型想成賽車。
模型設計是引擎技術。
研究團隊是車手與工程師。
但資料中心、GPU 與電力,就是賽道、維修站與燃料。
如果只有一台很好的車,卻沒有足夠燃料與維修資源,還是很難長時間參加最高等級的比賽。
Meta 現在做的,就是不只改引擎,而是連整個賽車場都一起擴建。
我們的觀察
Muse Wonder 真正值得注意的,可能不是某一項跑分,而是 Meta 的競爭方式愈來愈完整。
OpenAI 有模型與 Agent。
Google 有模型、搜尋、Workspace 與雲端。
Meta 則有模型、社群、廣告、穿戴裝置與數十億級的使用者入口。
當模型能力逐漸接近後,這些既有生態系的價值可能會被放大。
所以 AI 下一階段的問題未必只是:
「誰最聰明?」
而是:
誰能把最強模型最快送到最多人的生活裡。
對一般讀者的影響
對一般使用者來說,未來不一定會特別感覺自己正在「使用 Muse Wonder」。
更可能的情況是,Instagram、WhatsApp 或其他 Meta 服務裡的 AI 功能突然變得更會理解長對話、更能處理複雜任務,甚至能替使用者完成更多事情。
AI 模型愈深入原本就在使用的 App,使用者主動「打開一個 AI 工具」的感覺可能會愈來愈淡。
Gemini 4 Argon 支援百萬 Token,Google 瞄準的是「一整個專案」而不是一句回答
新聞重點
Google 推出 Gemini 4 Argon,鎖定程式開發、金融、法律、資安等高難度企業工作,並把長上下文能力列為主要賣點之一。
Argon 支援約百萬 Token 等級的上下文,可一次處理大量程式碼、長篇文件與跨檔案資料,特別適合大型專案分析、程式重構與資安問題處理。
Google 也把 Argon 推向全球開發者與企業市場,並透過定價優惠降低初期導入門檻,希望加快企業測試與採用速度。
不過,「支援一百萬 Token」代表的是能接收大量資訊,並不等於模型對所有內容都能百分之百準確記住或理解。長上下文仍會受到任務設計、資料品質與模型注意力分配影響。
背景脈絡
企業真正使用 AI 時,常遇到一個很實際的問題:
資料太多。
一個大型程式專案可能有幾十萬行程式碼。
一個法律案件可能包含大量合約與附件。
金融分析可能需要同時閱讀財報、新聞、研究資料與內部文件。
如果 AI 一次只能看到其中很小一部分,就很容易失去前後關係。
所以長上下文正在變成企業模型的重要能力。
知識點補充
Token 是大型語言模型處理內容的基本單位。
它不是單純等於一個中文字或一個英文單字,而是模型將文字拆分後使用的計算單位。
「百萬 Token 上下文」可以簡單理解成:
AI 的工作桌面變得非常大。
以前只能同時攤開幾十份文件。
現在可以同時放更多資料,減少一直摘要、刪除舊資訊或重新上傳文件的需求。
但桌面變大,不代表人就一定看得更仔細。
模型同樣可能漏掉藏在大量內容中的細節,因此企業仍需要良好的資料整理與驗證流程。
生活化說法
想像請一名律師研究一個大型案件。
以前桌子只能放五個資料夾,看到第六個就要先把前面的收起來。
現在換成一間超大的會議室,所有合約、證據、會議紀錄都可以同時攤開。
工作的確會順很多。
但最後能不能找出藏在第 378 頁的小細節,還是考驗分析能力,而不是只看桌面有多大。
我們的觀察
Google 這次把 Argon 定位在高難度企業任務,也反映 AI 市場正在逐漸分層。
日常問答需要的是快與便宜。
企業核心工作則更看重長上下文、推理、工具使用與可靠度。
因此未來 AI 公司可能不再只有一個「旗艦模型」,而是針對不同成本與任務提供不同層級。
真正的企業競爭,也會從「模型一次回答多漂亮」,轉向:
它能不能把一個大型工作流程穩定地跑完。
對一般讀者的影響
長上下文模型成熟後,最直接的改變就是 AI 能處理更大型的資料。
例如整本企劃書、長篇研究資料、多份合約,甚至跨多個檔案的工作,都比較不需要切成很多小段。
對上班族與開發者而言,AI 可能逐漸從「幫我寫一段」變成「幫我看完整個專案」。
Meta 押注 AI Agent,祖克柏格想把 AI 從聊天框帶進購物、眼鏡與日常生活
新聞重點
Meta 執行長祖克柏格近期談到公司對下一階段 AI 的想像,重點已明顯從單純聊天模型轉向個人 AI Agent。
他認為,未來 AI 應該更理解使用者的興趣、習慣與需求,進一步協助購物、內容推薦與生活任務。
智慧眼鏡也被 Meta 視為重要入口之一。
相較手機必須拿出來操作,眼鏡可以一直存在於使用者視野與環境中,更適合成為即時、持續性的 AI 介面。
Meta 同時擴大資料中心、晶片與其他 AI 基礎建設,並希望未來從商務、廣告、服務與訂閱等不同方向找到新的收入來源。
背景脈絡
聊天機器人的商業模式有一個限制:
人要主動來問。
但如果 AI 變成 Agent,它可以更深入參與生活。
例如:
知道你常買什麼。
發現某個商品快用完。
根據預算找到替代品。
最後在你確認後完成交易。
這時 AI 就不只是「回答者」,而開始站到消費入口的位置。
對 Meta 而言,這特別重要。
因為它本來就掌握廣告與社群推薦,如果 AI 再進一步介入購物決策,商業價值可能遠高於單純提供聊天服務。
知識點補充
這裡的重要概念叫做 Personal AI Agent,也就是個人 AI 代理人。
和一般聊天機器人相比,它通常多三個能力:
第一,記得更多你的背景與偏好。
第二,可以使用外部服務與工具。
第三,能替你執行某些動作。
例如普通 AI 可以回答:
「東京有哪些好吃的燒肉?」
個人 Agent 則可能根據你的預算、地點、過往喜好與行程,挑出幾家有空位的餐廳,再協助預訂。
能力愈往後者發展,對個人資料與帳號權限的需求也愈高。
生活化說法
傳統搜尋就像你自己去逛百貨公司。
AI 聊天工具比較像詢問服務台:
「哪一樓有鞋子?」
AI Agent 則更接近:
你告訴它尺寸、預算、喜歡的款式,它先替你找好幾雙,排除不適合的,最後只請你選一雙。
方便很多。
但同時,它也需要知道更多關於你的資訊。
我們的觀察
Meta 的策略很清楚:
如果未來真正重要的是 Agent,那麼「誰最了解使用者」可能比「誰有最好的聊天畫面」更加重要。
而 Meta 恰好擁有社群、興趣圖譜、廣告系統與穿戴設備。
這些資產組合起來,讓它在個人化 Agent 上具備非常特殊的優勢。
但同樣的優勢也會變成最大的爭議。
AI 如果需要大量理解個人習慣才能做到真正個人化,隱私、資料使用範圍與授權就會變得更加敏感。
因此 Meta 未來真正需要證明的,可能不只是 Muse 能多聰明,而是:
使用者願不願意讓它了解自己到這個程度。
對一般讀者的影響
未來 AI 可能不再只存在 ChatGPT 或 Claude 的對話頁面裡。
它會逐漸出現在社群、眼鏡、購物、行程與生活服務中。
對使用者而言,最明顯的改變可能是少掉很多搜尋與切換 App 的時間。
但同時,我們也會更常需要決定:
哪些資料可以讓 AI 知道?
哪些事情可以交給它處理?
哪些操作仍然必須自己確認?
我們的觀察
今天三則新聞表面上都在談大型模型,但真正值得注意的,其實不是「Meta 和 Google 又各發了一個新品」。
更深一層看,AI 的競爭正在形成三個新的層次。
第一層是模型能力。
Muse Wonder、Gemini 4 Argon 都想證明自己能處理更複雜、更長時間的任務。
第二層是基礎建設能力。
如果公司沒有足夠的 GPU、資料中心、電力與資本,再好的模型也很難擴大到數億甚至數十億使用者。
第三層則可能最關鍵:
誰掌握最後的使用者入口。
Meta 有 Instagram、WhatsApp、Facebook 與智慧眼鏡。
Google 有搜尋、Android、Workspace 與雲端。
OpenAI 則透過 ChatGPT、Work 與 Agent 服務試圖建立自己的入口。
當不同公司的模型能力逐漸接近,真正的差異可能不再只是 Benchmark 上幾個百分點。
而是:
誰能讓 AI 最自然地出現在人的工作與生活中。
所以未來 AI 戰爭可能不會只產生一個「最強模型」。
更可能形成幾個大型生態系,每一家公司都試圖讓自己的 AI 成為使用者每天最先接觸、也最願意交付任務的那一個入口。
模型決定它「有多聰明」。
算力決定它「能服務多少人」。
而 Agent 與生態系,最後決定的可能是——
人到底會不會每天真的用它。
資料來源
- 聯合新聞網|Meta Muse Wonder、AI 資本支出與台灣供應鏈相關報導
- https://udn.com/news/story/7240/9812805
- ETtoday AI|Google Gemini 4 Argon 模型與百萬 Token 相關報導
- https://ai.ettoday.net/news/3254188
- AI Post Hub|祖克柏格談 AI Agent、個人化服務與 Meta AI 投資布局
- Wonder 追上前沿模型,Meta 的真正底牌可能是「算力+社群入口」
- 新聞重點
- Meta 推出新一代 Muse Wonder 系列模型,定位明顯瞄準目前最強的一線 AI 模型,主打推理、寫作、程式開發與複雜任務處理。
- 依 Meta 公開說法,Muse Wonder 在部分測試中已經能和 OpenAI、Anthropic 等競爭對手拉近差距,部分項目甚至取得領先表現。不過,不同 Benchmark 的測試條件與評估方式並不完全相同,因此更適合把結果理解為「Meta 已進入前沿模型競爭區」,而不是簡化成全面超越所有對手。
- 祖克柏格也強調,這次模型突破與 Meta 大規模投入 GPU、資料中心與基礎建設密切相關。市場目前關注 Meta 明年的資本支出可能進一步上升至接近 2,000 億美元等級,但實際金額仍應以公司正式財測與公告為準。
- 台灣市場同時關注伺服器與資料中心供應鏈,包括鴻海、廣達、緯創、緯穎等業者是否會因大型雲端業者持續擴充 AI 基礎設施而增加訂單。不過,供應鏈「可能受惠」屬產業推估,仍會受到客戶分配、產品組合與實際投資進度影響。
- 背景脈絡
- Meta 過去在 AI 市場有一個很特別的位置。
- 它不缺使用者。
- Facebook、Instagram、WhatsApp 本來就掌握全球龐大的社群入口。
- 真正的問題是,在最高階模型競爭中,市場長期更常把 OpenAI、Google 與 Anthropic 放在第一排。
- Muse Wonder 的意義,就是讓 Meta 嘗試補上這一塊。
- 一旦模型能力、算力、社群平台與個人 AI Agent 都掌握在同一家公司手上,Meta 就不只是提供模型,而是能把 AI 從資料中心一路送到一般人的社群、購物與日常使用情境。
- 知識點補充
- 這則新聞最重要的概念之一,是 AI 資本支出(AI Capex)。
- Capex 指的是資本支出,也就是公司用來蓋資料中心、買伺服器、GPU、網路設備與電力設施的長期投資。
- 大型 AI 模型要持續進步,不只是研究人員寫出更好的演算法而已。
- 背後還需要:
- 更多高階晶片。
- 更大的資料中心。
- 更快的網路。
- 更多電力與散熱設備。
- 所以現在 AI 模型競爭,某種程度也是「誰能長期負擔巨額基礎建設」的競爭。
- 生活化說法
- 可以把 AI 模型想成賽車。
- 模型設計是引擎技術。
- 研究團隊是車手與工程師。
- 但資料中心、GPU 與電力,就是賽道、維修站與燃料。
- 如果只有一台很好的車,卻沒有足夠燃料與維修資源,還是很難長時間參加最高等級的比賽。
- Meta 現在做的,就是不只改引擎,而是連整個賽車場都一起擴建。
- 編輯觀察
- Muse Wonder 真正值得注意的,可能不是某一項跑分,而是 Meta 的競爭方式愈來愈完整。
- OpenAI 有模型與 Agent。
- Google 有模型、搜尋、Workspace 與雲端。
- Meta 則有模型、社群、廣告、穿戴裝置與數十億級的使用者入口。
- 當模型能力逐漸接近後,這些既有生態系的價值可能會被放大。
- 所以 AI 下一階段的問題未必只是:
- 「誰最聰明?」
- 而是:
- 誰能把最強模型最快送到最多人的生活裡。
- 對一般讀者的影響
- 對一般使用者來說,未來不一定會特別感覺自己正在「使用 Muse Wonder」。
- 更可能的情況是,Instagram、WhatsApp 或其他 Meta 服務裡的 AI 功能突然變得更會理解長對話、更能處理複雜任務,甚至能替使用者完成更多事情。
- AI 模型愈深入原本就在使用的 App,使用者主動「打開一個 AI 工具」的感覺可能會愈來愈淡。
- Gemini 4 Argon 支援百萬 Token,Google 瞄準的是「一整個專案」而不是一句回答
- 新聞重點
- Google 推出 Gemini 4 Argon,鎖定程式開發、金融、法律、資安等高難度企業工作,並把長上下文能力列為主要賣點之一。
- Argon 支援約百萬 Token 等級的上下文,可一次處理大量程式碼、長篇文件與跨檔案資料,特別適合大型專案分析、程式重構與資安問題處理。
- Google 也把 Argon 推向全球開發者與企業市場,並透過定價優惠降低初期導入門檻,希望加快企業測試與採用速度。
- 不過,「支援一百萬 Token」代表的是能接收大量資訊,並不等於模型對所有內容都能百分之百準確記住或理解。長上下文仍會受到任務設計、資料品質與模型注意力分配影響。
- 背景脈絡
- 企業真正使用 AI 時,常遇到一個很實際的問題:
- 資料太多。
- 一個大型程式專案可能有幾十萬行程式碼。
- 一個法律案件可能包含大量合約與附件。
- 金融分析可能需要同時閱讀財報、新聞、研究資料與內部文件。
- 如果 AI 一次只能看到其中很小一部分,就很容易失去前後關係。
- 所以長上下文正在變成企業模型的重要能力。
- 知識點補充
- Token 是大型語言模型處理內容的基本單位。
- 它不是單純等於一個中文字或一個英文單字,而是模型將文字拆分後使用的計算單位。
- 「百萬 Token 上下文」可以簡單理解成:
- AI 的工作桌面變得非常大。
- 以前只能同時攤開幾十份文件。
- 現在可以同時放更多資料,減少一直摘要、刪除舊資訊或重新上傳文件的需求。
- 但桌面變大,不代表人就一定看得更仔細。
- 模型同樣可能漏掉藏在大量內容中的細節,因此企業仍需要良好的資料整理與驗證流程。
- 生活化說法
- 想像請一名律師研究一個大型案件。
- 以前桌子只能放五個資料夾,看到第六個就要先把前面的收起來。
- 現在換成一間超大的會議室,所有合約、證據、會議紀錄都可以同時攤開。
- 工作的確會順很多。
- 但最後能不能找出藏在第 378 頁的小細節,還是考驗分析能力,而不是只看桌面有多大。
- 編輯觀察
- Google 這次把 Argon 定位在高難度企業任務,也反映 AI 市場正在逐漸分層。
- 日常問答需要的是快與便宜。
- 企業核心工作則更看重長上下文、推理、工具使用與可靠度。
- 因此未來 AI 公司可能不再只有一個「旗艦模型」,而是針對不同成本與任務提供不同層級。
- 真正的企業競爭,也會從「模型一次回答多漂亮」,轉向:
- 它能不能把一個大型工作流程穩定地跑完。
- 對一般讀者的影響
- 長上下文模型成熟後,最直接的改變就是 AI 能處理更大型的資料。
- 例如整本企劃書、長篇研究資料、多份合約,甚至跨多個檔案的工作,都比較不需要切成很多小段。
- 對上班族與開發者而言,AI 可能逐漸從「幫我寫一段」變成「幫我看完整個專案」。
- Meta 押注 AI Agent,祖克柏格想把 AI 從聊天框帶進購物、眼鏡與日常生活
- 新聞重點
- Meta 執行長祖克柏格近期談到公司對下一階段 AI 的想像,重點已明顯從單純聊天模型轉向個人 AI Agent。
- 他認為,未來 AI 應該更理解使用者的興趣、習慣與需求,進一步協助購物、內容推薦與生活任務。
- 智慧眼鏡也被 Meta 視為重要入口之一。
- 相較手機必須拿出來操作,眼鏡可以一直存在於使用者視野與環境中,更適合成為即時、持續性的 AI 介面。
- Meta 同時擴大資料中心、晶片與其他 AI 基礎建設,並希望未來從商務、廣告、服務與訂閱等不同方向找到新的收入來源。
- 背景脈絡
- 聊天機器人的商業模式有一個限制:
- 人要主動來問。
- 但如果 AI 變成 Agent,它可以更深入參與生活。
- 例如:
- 知道你常買什麼。
- 發現某個商品快用完。
- 根據預算找到替代品。
- 最後在你確認後完成交易。
- 這時 AI 就不只是「回答者」,而開始站到消費入口的位置。
- 對 Meta 而言,這特別重要。
- 因為它本來就掌握廣告與社群推薦,如果 AI 再進一步介入購物決策,商業價值可能遠高於單純提供聊天服務。
- 知識點補充
- 這裡的重要概念叫做 Personal AI Agent,也就是個人 AI 代理人。
- 和一般聊天機器人相比,它通常多三個能力:
- 第一,記得更多你的背景與偏好。
- 第二,可以使用外部服務與工具。
- 第三,能替你執行某些動作。
- 例如普通 AI 可以回答:
- 「東京有哪些好吃的燒肉?」
- 個人 Agent 則可能根據你的預算、地點、過往喜好與行程,挑出幾家有空位的餐廳,再協助預訂。
- 能力愈往後者發展,對個人資料與帳號權限的需求也愈高。
- 生活化說法
- 傳統搜尋就像你自己去逛百貨公司。
- AI 聊天工具比較像詢問服務台:
- 「哪一樓有鞋子?」
- AI Agent 則更接近:
- 你告訴它尺寸、預算、喜歡的款式,它先替你找好幾雙,排除不適合的,最後只請你選一雙。
- 方便很多。
- 但同時,它也需要知道更多關於你的資訊。
- 編輯觀察
- Meta 的策略很清楚:
- 如果未來真正重要的是 Agent,那麼「誰最了解使用者」可能比「誰有最好的聊天畫面」更加重要。
- 而 Meta 恰好擁有社群、興趣圖譜、廣告系統與穿戴設備。
- 這些資產組合起來,讓它在個人化 Agent 上具備非常特殊的優勢。
- 但同樣的優勢也會變成最大的爭議。
- AI 如果需要大量理解個人習慣才能做到真正個人化,隱私、資料使用範圍與授權就會變得更加敏感。
- 因此 Meta 未來真正需要證明的,可能不只是 Muse 能多聰明,而是:
- 使用者願不願意讓它了解自己到這個程度。
- 對一般讀者的影響
- 未來 AI 可能不再只存在 ChatGPT 或 Claude 的對話頁面裡。
- 它會逐漸出現在社群、眼鏡、購物、行程與生活服務中。
- 對使用者而言,最明顯的改變可能是少掉很多搜尋與切換 App 的時間。
- 但同時,我們也會更常需要決定:
- 哪些資料可以讓 AI 知道?
- 哪些事情可以交給它處理?
- 哪些操作仍然必須自己確認?
- 我們的總觀察
- 今天三則新聞表面上都在談大型模型,但真正值得注意的,其實不是「Meta 和 Google 又各發了一個新品」。
- 更深一層看,AI 的競爭正在形成三個新的層次。
- 第一層是模型能力。
- Muse Wonder、Gemini 4 Argon 都想證明自己能處理更複雜、更長時間的任務。
- 第二層是基礎建設能力。
- 如果公司沒有足夠的 GPU、資料中心、電力與資本,再好的模型也很難擴大到數億甚至數十億使用者。
- 第三層則可能最關鍵:
- 誰掌握最後的使用者入口。
- Meta 有 Instagram、WhatsApp、Facebook 與智慧眼鏡。
- Google 有搜尋、Android、Workspace 與雲端。
- OpenAI 則透過 ChatGPT、Work 與 Agent 服務試圖建立自己的入口。
- 當不同公司的模型能力逐漸接近,真正的差異可能不再只是 Benchmark 上幾個百分點。
- 而是:
- 誰能讓 AI 最自然地出現在人的工作與生活中。
- 所以未來 AI 戰爭可能不會只產生一個「最強模型」。
- 更可能形成幾個大型生態系,每一家公司都試圖讓自己的 AI 成為使用者每天最先接觸、也最願意交付任務的那一個入口。
- 模型決定它「有多聰明」。
- 算力決定它「能服務多少人」。
- 而 Agent 與生態系,最後決定的可能是——
- 人到底會不會每天真的用它。
- 資料來源
- 聯合新聞網|Meta Muse Wonder、AI 資本支出與台灣供應鏈相關報導
- https://udn.com/news/story/7240/9812805
- ETtoday AI|Google Gemini 4 Argon 模型與百萬 Token 相關報導
- https://ai.ettoday.net/news/3254188
- AI Post Hub|祖克柏格談 AI Agent、個人化服務與 Meta AI 投資布局
- https://www.aiposthub.com/cheeky-pint-zuckerberg-wang-ai-agents-capex/
延伸閱讀
作者:NineLife AI 編輯室
最後更新:2026年10月14日
本文由 NineLife AI 編輯室整理公開資料後撰寫,可能使用 AI 工具協助草稿整理;發布前會人工檢查來源、事實與語意。內容僅供資訊參考,不構成法律、投資、醫療、稅務或其他專業建議。
留言
張貼留言
留言會先經過審核。歡迎補充觀點或來源;請勿張貼廣告、無關連結、成人、賭博、藥品或自動產生的內容。