Gemini 4 Argon 登場
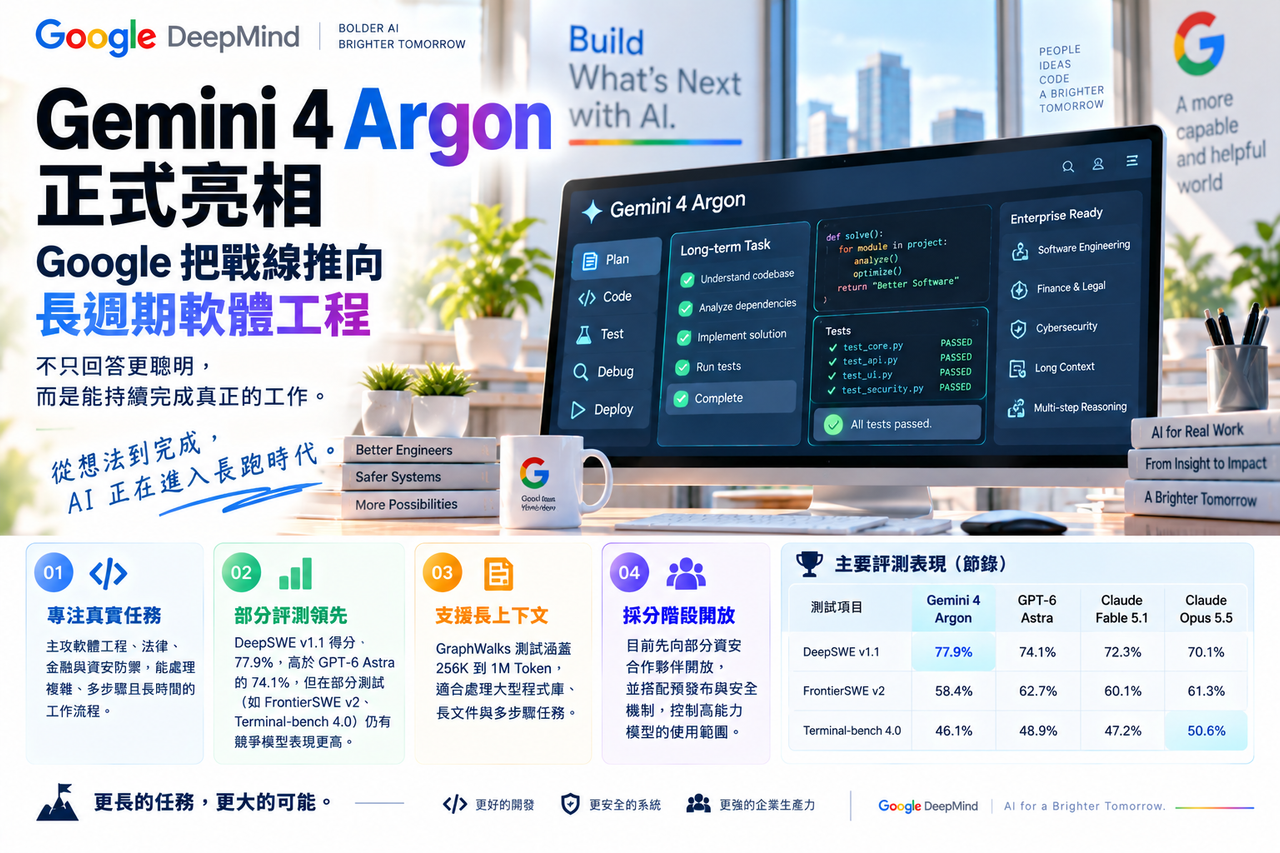
Gemini 4 Argon 正式亮相,Google 把戰線推向長週期軟體工程
新聞重點
Google DeepMind 正式公開 Gemini 4 Argon,定位為新一代旗艦模型,主攻真實軟體工程、法律與金融等企業知識工作,以及資安防禦。Google 官方表示,Argon 能處理複雜、多步驟且持續時間較長的工作流程,並強調它在程式開發與企業任務上的能力。Google DeepMind:https://deepmind.google/models/gemini/?authuser=50&hl=ja
從 Google 公布的評測來看,Argon 在部分長週期軟體工程與企業自動化測試上領先 GPT-6 Astra、Claude Fable 5.1 與 Claude Opus 5.5,但並不是所有程式測試都全面領先。例如 DeepSWE v1.1 中 Argon 得分 77.9%,高於 GPT-6 Astra 的 74.1%;但在 FrontierSWE v2 與 Terminal-bench 4.0 上,部分競爭模型仍高於 Argon。Google DeepMind:https://deepmind.google/models/gemini/?authuser=50&hl=ja
Argon 也支援長上下文處理,Google 公布的 GraphWalks 測試涵蓋 256K 到 1M Token 範圍,顯示模型被設計來處理大型程式庫、長文件與多步驟任務。Google DeepMind:https://deepmind.google/models/gemini/?authuser=50&hl=ja
目前 Google 並未一次全面開放。Reuters 報導指出,Argon 先向部分資安合作夥伴開放,Google 同時透過相關預發布與安全機制控制高能力模型的使用範圍。Reuters:https://www.reuters.com/legal/litigation/google-announces-gemini-4-flagship-ai-model-after-months-delays-2026-09-30/?utm_source=chatgpt.com
背景脈絡
過去大型語言模型的競爭,很容易變成「誰回答得比較聰明」。
但真正進入企業之後,使用情境完全不同。
一家公司真正需要的,可能不是模型幫忙寫一小段程式,而是要它理解幾十萬行程式碼、追蹤多個檔案之間的依賴關係,找出 Bug,再完成修改與測試。
這類任務有一個共同特徵:時間長、資料多,而且需要連續記住前面做過什麼。
因此 Gemini 4 Argon 的意義,不只是模型分數又提高,而是 Google 明確把競爭重心放到「持續工作能力」。
知識點補充
這則新聞最重要的概念之一,是 Context Window,也就是上下文視窗。
上下文視窗可以理解成 AI 一次能「放在工作桌面上」的資訊量。
如果上下文很小,AI 看完前面的文件,讀到後面可能就忘記前面的細節;上下文越大,就越能同時理解長篇文件、大型程式碼與多份資料。
一百萬 Token 不等於 AI 就一定能完美理解一百萬 Token,但它代表模型可以一次接收非常大量的資訊,而不需要一直把資料切得很碎。
另外還有一個重要概念叫 長週期任務(Long-horizon task)。
它不是問一個問題、拿一個答案,而是 AI 要完成很多步驟,例如讀程式碼、找問題、修改、執行測試、檢查錯誤,再重新修正。
這也是 Gemini 4 Argon 會特別強調軟體工程與資安的原因。
生活化說法
可以把傳統 AI 想像成一位很聰明的臨時工。
你交給他一張文件,他很快就能整理好。
但 Gemini 4 Argon 想處理的,比較像是「整間公司的檔案室」。
它不只是看一張紙,而是要記得不同文件之間有什麼關係,今天做到哪裡,明天還能接著做。
這對大型企業來說,差別很大。
因為真正昂貴的工作,往往不是回答一個問題,而是處理一整串複雜流程。
我們的觀察
Gemini 4 Argon 最值得注意的地方,不是「Google 終於追上誰」,而是 AI 競爭正在開始從單次能力轉向工作持久度與流程掌控能力。
但官方 Benchmark 仍然只是衡量工具之一。
Google 公布的結果顯示 Argon 在部分測試確實領先,但不同測試仍各有勝負,因此不能簡化成「全面打敗 OpenAI 與 Anthropic」。Google DeepMind:https://deepmind.google/models/gemini/?authuser=50&hl=ja
真正決定企業是否採用的,還會包括價格、穩定性、安全性、權限控制,以及能不能整合既有系統。
換句話說,模型跑分可能決定大家會不會注意它,但真正能不能留下來,還是看它在工作現場能不能少出錯。
對一般讀者的影響
一般人未必需要一次處理百萬 Token,但這類能力最後會反映在產品體驗上。
AI 可能更能看懂整份企劃、長篇合約、大量郵件或大型程式專案,而不必一直要求使用者重新解釋前面的內容。
對工程師與知識工作者來說,AI 的角色也可能進一步從「幫忙寫一小段」變成「一起完成整個專案流程」。
海事保賠產業也談 AI,效率提高後更不能少掉專業判斷
新聞重點
國際保賠協會集團(International Group of P&I Clubs)於倫敦舉辦國際聯絡人會議,活動時間為 9 月 29 日至 10 月 1 日,聚集來自不同國家的保賠協會代表、律師與海事專業人士。官方將這類會議定位為跨國海事實務交流平台,用來討論事故、索賠、法律責任與跨境合作。IG Conference:https://www.igconference.org/event/2026/summary?utm_source=chatgpt.com
P&I,也就是 Protection & Indemnity,主要處理船東與營運相關的第三方責任,包括人員傷亡、貨物損失、污染、碰撞與殘骸移除等。國際保賠協會集團旗下會員協會,涵蓋全球約 87% 遠洋船舶噸位,因此相關制度與協調方式對國際航運具有重要影響。LinkedIn:https://uk.linkedin.com/company/international-group-of-p%26i-clubs?utm_source=chatgpt.com
本次相關報導也把 AI 列為討論焦點之一,關注它是否能協助索賠資料整理、事故分析與行政效率,同時仍保留法律、責任與專業判斷。
背景脈絡
海事保險是一個非常適合 AI,卻也很難完全交給 AI 的產業。
一次船舶事故可能牽涉貨物、船員、港口、污染、法律責任、多國法規與保險條款。
大量文件、照片、航行紀錄與事故報告,確實很適合讓 AI 幫忙整理。
但真正的責任判斷卻不能只靠「模型覺得」。
因為最後結果可能影響數百萬美元甚至更高金額的理賠,也可能牽涉不同國家的法律責任。
因此海事產業導入 AI 的重點,很可能不是取代專業人士,而是讓專家少花時間找資料,把更多時間留給真正需要判斷的地方。
知識點補充
P&I 的全名是 Protection and Indemnity Insurance,保護與賠償保險。
它和一般船體保險不太一樣。
船體保險主要保障「船本身」,而 P&I 更偏向保障船舶營運產生的第三方責任。
例如船撞到別人的船、貨物損壞、油污染海域,或船員發生事故,都可能進入 P&I 處理範圍。
AI 在這裡比較適合的角色,通常是把大量文件先分類、找出相關條款、整理事件時間線或協助查找案例。
最後涉及責任歸屬與談判時,仍需要保險、法律與海事專業人員判斷。
生活化說法
可以把它想成處理一場大型車禍。
AI 很擅長把監視器畫面、車主資料、保單、維修估價與警方紀錄全部整理好。
但最後誰負多少責任、保險公司該賠多少、法律上怎麼處理,還是不能只讓一個系統按按鈕決定。
海事理賠只是把這件事放大很多倍,而且常常一次牽涉好幾個國家。
我們的觀察
這則新聞反映一個很容易被忽略的 AI 趨勢:AI 最先改變的,可能不是最終決策,而是決策之前的資料處理。
對高度專業產業來說,AI 如果能把 500 頁文件整理成 20 頁重點,本身就已經能節省很多時間。
真正危險的反而是企業為了追求效率,把「整理資料」一路延伸成「自動下結論」。
因此未來成熟的專業 AI 系統,很可能會刻意保留一道人工判斷關卡。
不是因為 AI 沒有價值,而是因為有些決策最後必須有人負責。
對一般讀者的影響
一般人可能很少直接接觸海事保賠,但它和全球物流、商品運輸與供應鏈都有關。
如果 AI 能提高事故處理與理賠效率,可能讓跨國航運在發生事故後更快整理資訊。
但對任何涉及高額責任的產業而言,這則新聞也有一個共通提醒:AI 可以幫忙縮短流程,不代表責任也能一起自動化。
員工用 AI 寫作要標示?科技公司開始反思「生成太容易」
新聞重點
隨著 ChatGPT、Claude 等工具大量進入職場,一些科技新創開始要求員工,如果文字由 AI 協助生成,就必須主動標示。
Business Insider 報導,AI 新創與科技公司出現多種不同做法。例如 Clay 要求員工對 AI 協助產出的內容負完全責任;Figma 會加上「written with AI」標示;Dupe.com 則使用特定符號標記 AI 內容;AI 搜尋公司 Exa 對部分對外內容甚至採取更嚴格限制。Business Insider:https://www.businessinsider.com/ai-startups-asking-employees-to-flag-ai-writing-clay-figma-2026-9?utm_source=chatgpt.com
背後原因之一,不是公司突然反對 AI,而是員工發現 AI 讓寫作變得太容易後,可能產生更多冗長、模糊或缺乏思考的文字,最後反而把理解成本轉嫁給讀者。Business Insider:https://www.businessinsider.com/companies-writing-ai-policies-stop-ai-slop-2026-8?utm_source=chatgpt.com
這種做法目前並不是整個科技業統一的新規,而是部分公司自行建立的內部政策。
背景脈絡
生成式 AI 最大的優勢之一,就是把「寫出一大段文字」的成本降得非常低。
但這也產生一個新的問題。
以前寫一份三頁報告需要一小時,所以人會先想:「這件事真的值得寫三頁嗎?」
現在 AI 十秒鐘就能產生三頁內容,產出變容易後,真正變貴的反而可能是「別人要花多少時間把它看懂」。
因此部分公司開始重新要求:
可以用 AI。
但不能因為 AI 幫你寫了,就把思考責任一起交出去。
知識點補充
這裡值得區分兩個概念:AI-assisted writing 和 AI-generated writing。
AI-assisted writing 是 AI 協助寫作。
例如你自己先決定觀點,再請 AI 修正文法、整理段落或檢查錯字。
AI-generated writing 則更接近把整個內容交給模型直接生成。
兩者的界線有時很模糊,因此公司開始要求標示 AI 參與程度。
這種標示的目的,不一定是判定「AI 寫的就是不好」,而是讓讀者知道內容是怎麼產生的,也讓作者保留責任。
生活化說法
以前同事傳一封很長的 Email 給你,你通常會假設:
「他應該花了不少時間整理,所以裡面大概都很重要。」
現在 AI 十幾秒就能寫出三千字。
結果可能變成寄件人花 30 秒生成,但收件人卻花 10 分鐘閱讀。
這就像有人用機器瞬間印出一本 100 頁報告,然後叫所有同事自己慢慢找重點。
產出效率提高了,不代表溝通效率也提高。
我們的觀察
這可能是生成式 AI 進入職場後很有意思的一次反轉。
前兩年大家努力鼓勵員工「多用 AI」。
現在部分 AI 公司反而開始說:
可以用,但請告訴別人你用了,而且最後那段話仍然算你的。
這反映企業對 AI 的期待正在從「使用率」轉向「使用品質」。
未來一個員工會不會使用 AI,可能沒那麼重要;真正重要的是他能不能判斷:
哪些事情值得讓 AI 幫忙,哪些內容應該自己重新思考,以及 AI 產出的東西到底值不值得別人花時間閱讀。
對一般讀者的影響
未來我們可能會越來越常看到「AI 協助撰寫」、「部分由 AI 生成」或其他透明標示。
對一般使用者來說,這未必代表內容比較不可信,而是多了一項判斷資訊。
更重要的是,在工作場合使用 AI 後,「這是 AI 寫的」可能不能再成為錯誤的理由。
最後把文件寄出去的人,仍然需要知道自己到底說了什麼。
我們的觀察
今天三則新聞其實剛好落在 AI 進入工作的三個不同階段。
Gemini 4 Argon 在回答第一個問題:AI 能不能處理更長、更複雜的工作?
海事保賠產業則在處理第二個問題:AI 進入專業流程後,哪個環節應該交給它?
而科技公司的 AI 寫作標示,又進一步追問:如果 AI 參與了工作,最後誰要為結果負責?
這三個問題合在一起,可能比單純比較模型排行榜更接近真正的 AI 未來。
模型能力繼續提升幾乎可以預期,但企業真正會遇到的難題,是如何重新分配「產出、判斷與責任」。
AI 可以讀一百萬 Token,不代表每一段結論都應直接採用;AI 可以快速整理一份海事索賠,不代表責任可以自動判定;AI 可以幾秒鐘寫完報告,也不代表讀者就必須接受一大篇沒有經過思考的文字。
所以接下來的 AI 職場競爭,可能會出現一個新的分水嶺:
不是誰生成得最多,而是誰知道哪些東西值得生成、哪些地方一定要停下來由人判斷。
當 AI 的「做事能力」越來越強,人類真正稀缺的能力,反而可能慢慢從生產內容轉向選擇、判斷與負責。
資料來源
- Google DeepMind|Gemini 4 Argon 官方模型頁面 Gemini 4 Argon
- Reuters|Google 發表 Gemini 4 Argon Reuters 報導
- International Group of P&I Clubs|2026 International Group Correspondents Conference 會議官方資訊
- Business Insider|科技公司要求標示 AI 寫作
延伸閱讀
作者:NineLife AI 編輯室
最後更新:2026年10月1日
本文由 NineLife AI 編輯室整理公開資料後撰寫,可能使用 AI 工具協助草稿整理;發布前會人工檢查來源、事實與語意。內容僅供資訊參考,不構成法律、投資、醫療、稅務或其他專業建議。
留言
張貼留言
留言會先經過審核。歡迎補充觀點或來源;請勿張貼廣告、無關連結、成人、賭博、藥品或自動產生的內容。