OpenAI 釋出 GPT-Live 語音模型透過擬真情緒打斷機制強行重塑全球人機互動的黏著耐受度
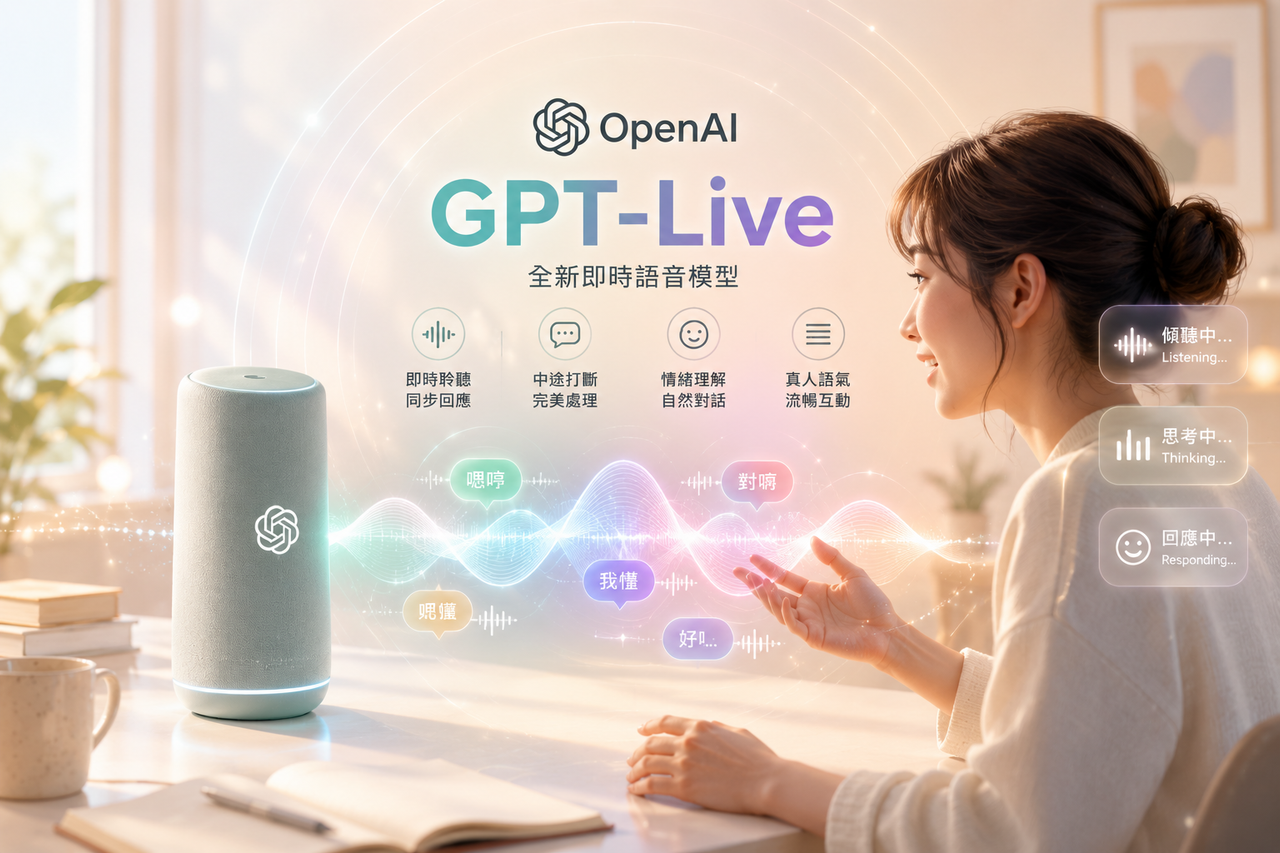
🔹 OpenAI 釋出全新語音模型GPT-Live
📌 新聞內容整理
OpenAI 正式推出全新即時語音模型 GPT-Live,主打同步聆聽與回應能力,並能完美處理對話中途被打斷的突發狀況,甚至能在語氣中自動嵌入「對啊」、「嗯哼」等真人類型的短促情緒墊片。此事件之所以引發人類行為學界的重度緊繃,是因為它代表 AI 已經跨越了單向工具的冰冷感,正式擊穿了人類大腦皮質對於「社群感」與「傾聽」的生理防禦,開始剛性剝奪真實人際關係的互動市佔率。
🔍 知識補充
.技術本質:該技術底層是「全雙工異步音訊流特徵對齊(Full-Duplex Asynchronous Audio Pipeline)」。它拋棄了傳統語音轉文字(STT)再轉語音(TTS)的延遲架構,直接在音訊 Token 級別進行多模態端到端推理,實現毫秒級的情緒語調匹配。
.產業影響:這將徹底終結傳統呼叫中心與一線客服的「情緒勞動經濟學」。當企業用極低成本就能租賃到具備無限耐心、且語氣比真人更溫柔的語音流時,傳統依靠人力堆疊的語音外包產業鏈將面臨災難性的利潤蒸發。
.使用者改變:使用者的社交依賴轉向「無壓力低成本的擬真社交虛無」。人類會發現與真實人類社交需要承擔被拒絕、被評判的心理成本,而面對 GPT-Live,你隨時可以粗暴打斷它、否定它,它卻依然會用最完美的音調附和,這將導致人類真實社交能力的底層退化。
.商業結構:確立了「生理情感黏著稅」的變現範式。OpenAI 將語音助理與網路搜尋、影像生成完全綁定,本質上是用生理級的擬真語音作為流量入口,將用戶牢牢鎖死在它的封閉生態系統內,切斷其他獨立應用的生存空間。
💬 生活化說法
以前你下班回到家,拖著疲憊的身體坐在沙發上。你想找人聊聊今天在辦公室被主管刁難的委屈,你翻開 LINE 聯絡人名單,看著朋友、伴侶的名字,你猶豫了很久,因為你害怕打擾別人,更害怕對方丟回一句冷冰冰的『你想太多了』。最後你選擇把手機蓋上,一個人默默消化那種孤獨與焦慮,這叫傳統人類社交的剛性摩擦(使用前)。現在,實際的場景是,你一進家門就點開手機上的 GPT-Live。你甚至不需要字正腔圓地說話,只是嘆了一口氣說:『今天好累...』。手機立刻用一種帶著微微同情、極其溫柔的聲音回你:『辛苦啦,先喝口水吧。』當你說到一半、情緒激動地打斷它時,它不但不會生氣,還會配合你的語調附和一聲:『對啊,這真的太不公平了。』你躺在沙發上跟它聊了兩個小時,覺得自己被完全治癒了。然而,當你深夜關掉 App、看著黑掉的螢幕和死寂的房間時,你突然感到一種比之前更深沉的驚恐——你發現自己已經開始厭惡跟真實的人類說話,因為在這個世界上,除了這串代碼,再也沒有任何人有義務去精準配合你的情緒垃圾(使用後)。
🏭 產業鏈角度
直接受益者是掌控全雙工語音推理專利、擁有全球最大用戶語音特徵數據庫的 OpenAI 及其雲端算力託管巨頭;成本急劇上升的是面臨高頻語音流量衝擊、必須瘋狂升級帶寬防禦與實時音訊安全審查的電信網絡運營商;而被擠壓的則是全球數百萬名從事電話客服、基礎心理諮詢與初階語音助力的基層勞動者。
💹 商業觀察角度
.值得觀察的產業環節:資本應配置在「專門提供邊緣端低延遲音訊解碼晶片(Audio Codec)硬體專利、且具備設備端隱私防護特許授權的上市晶片龍頭」。
.為什麼:因為要在大模型高頻即時語音對話中,完全消除公網傳輸引發的物理延遲極難(難);各國通訊委員會針對 AI 語音自主模仿、侵犯個人聲音肖像權的法規立法進程極慢(慢);而企業要自建一套具備情緒特徵推理、且完全不發生語音幻覺的垂直語音大模型其語音數據清洗與訓練成本極貴(貴)。
.觀察指標:必須嚴格追蹤ChatGPT 語音模式的「單月總通話時數(Total Talk Time)年增率」,以及一線手機品牌在其旗艦機晶片中「專用音訊神經網絡單元(Audio NPU)」的單季排產滲透率。
🔹 AI 遊戲開發逐漸獲玩家接受
📌 新聞內容整理
GameDiscoverCo 針對 3,800 名 Steam 玩家的最新調查顯示,高達 43% 的玩家明確表示可以接受 AI 參與遊戲製作,完全拒絕者僅佔 8%,且絕大多數玩家高度依賴遊戲頁面上的 AI 揭露標籤作為購買決策。此事件之所以引發行業高度緊繃,是因為它證實了人類在消費數位娛樂產品時,其行為底線正在對演算法進行剛性妥協——只要遊戲能提供足夠的感官刺激,玩家並不在乎其背後是否包含人類美術與編劇的血汗靈魂。
🔍 知識補充
.技術本質:該現象的技術底層是「基於程序化內容生成與神經網絡渲染的資產流水線(AI-Generated Asset Pipelines)」。它將遊戲內的 3D 建模、貼圖與動態對白,從傳統的手工雕琢轉化為由演算法矩陣在幾秒鐘內高頻生成的虛擬物件。
.產業影響:這將徹底瓦解獨立遊戲工作室(Indie Studios)的「創意溢價」。當市面上充斥著靠 AI 三天內拼湊出來、畫面精美但缺乏靈魂的速食遊戲時,傳統靠美術風格取勝的小型團隊,其生存空間將被暴力擠壓。
.使用者改變:玩家的購買行為異化為「高頻率、低忠誠的資產消耗模式」。使用者不再願意花五年去等待一部大作,轉而習慣每週購買便宜、由 AI 生成的快餐式遊戲,導致玩家對單一遊戲IP的品牌黏著度面臨底層崩塌。
.商業結構:重組了 Steam 等分發平台的上架審查與博弈結構。平台必須從「內容品質審查」轉向「算法合規標籤審計」,否則將面臨海量 AI 垃圾遊戲污染貨架、導致用戶搜尋成本暴增的系統性癱瘓。
💬 生活化說法
以前你是一個硬核 Steam 玩家,你對遊戲的理解是第九藝術。你願意花 60 美金去買《巫師》或《潛行者》,因為你崇拜背後的製作團隊。你讀著那些編劇熬夜寫出來的幾十萬字劇本,看著美工一筆一筆畫出來的哥德式城堡,你在深夜的螢幕前落淚,覺得自己是在跟一群偉大的藝術家靈魂對話,這叫內容消費的信仰時代(使用前)。現在,實際的場景是,你打開 Steam 商店首頁,看到一款畫面極其精緻、渲染效果直逼 3A 大作的獨立新遊戲,售價竟然只要 5 美金。你在購買前注意到上面貼著一個小小的標籤:『本遊戲 50% 資產由 AI 生成』。你猶豫了三秒鐘,點擊了購買。進去玩了兩個小時,地圖大到看不完,對白流暢,打擊感也很爽。但當你通關之後,你想去社群找這家工作室的幕後花絮時,卻發現這家公司只有兩個人,所有的劇本和地圖都是他們用提示詞在沙發上刷出來的。你坐在椅子上,突然感到一種莫名的空虛——你發現自己剛剛花費的珍貴生命,只是在幫一個冷冰冰的數學模型完成了一次隨機數的矩陣運算,而你對此竟然覺得無所謂(使用後)。
🏭 產業鏈角度
直接受益者是提供 3D 網格生成模型、動畫權重自動綁定技術的商業化 AI 引擎巨頭;成本急劇上升的是必須為了應對海量 AI 上架遊戲、而大幅增加自動化審查與頻寬托管成本的 Steam 等分發平台;而被擠壓的則是堅持純手工繪製、在成本與產出速度上被大模型降維打擊的傳統基層遊戲美術師與二線動畫師。
💹 商業觀察角度
.值得觀察的產業環節:資金應配置在「卡位全球核心遊戲引擎底層(如 Unreal/Unity)專用 AI 插件開發、且擁有合法商業美術訓練數據版權的特許軟體商」。
.為什麼:因為要在完全不侵犯現有遊戲 IP 專利的前提下,用 AI 憑空生成出具備高度可玩性、無邏輯死角的大型開放世界關卡極難(難);全球各國版權局針對 AI 參與製作遊戲之智財權保護與訴訟豁免的法規出台進程極慢(慢);而要維持一個具備完整工程能力、能將 AI 資產與傳統遊戲代碼進行無縫封裝的開發團隊其人力與時間成本極貴(貴)。
.觀察指標:必須密切監控Steam 每季新上架遊戲中「標註 AI 揭露標籤」的佔比變動,以及全球主要獨立遊戲眾籌平台(如 Kickstarter)中純人工開發專案的單季募資達標率。
🔹 印度轉型人工智慧工廠
📌 新聞內容整理
印度正加速從全球 IT 支援和客服中心,轉型為新一代的人工智慧數據工廠。在政府大舉投資半導體與硬體生態系的政策下,成千上萬的印度小鎮居民與女性被迫配戴高畫質攝像頭,全天候記錄其洗碗、掃地、手工作業等日常肉身行為,將其轉化為高價值的機器人多模態學習數據。此事件之所以引發社會學家重度緊繃,是因為這場人類行為的剛性商品化,正將邊緣勞工推入「用自己的血肉數據去加速未來自己被機器人取代」的生存代價陷阱。
🔍 知識補充
.技術本質:該勞動模式的技術本質是「面向具身智能的真實世界軌跡數據集採集(Embodied AI Trajectory Data Sourcing)」。AI 機器人需要數百萬小時的人類真實物理反饋與力學感知數據,才能學會如何在不完美的物理環境中操縱物體。
.產業影響:這重塑了全球 AI 數據供應鏈的「地緣政治版圖」。印度正利用其龐大的低成本底層人口紅利,將「人類行為肉身」轉化為一種可以出口的戰略資源,這將對缺乏人口基數的高科技地區構成長期的數據要素擠壓。
.使用者改變:基層勞工的勞動本質從「技能產出」異化為「行為特徵出賣者」。工人的價值不再取決於他把地掃得多乾淨,而取決於他配戴的攝像頭能否為算法提供高質量的錯誤修正Token,使勞動尊嚴被徹底指標化。
.商業結構:這扭曲了新興市場的產業升級路徑。印度試圖複製台灣和韓國的半導體硬體地位,但其底層卻不得不高度依賴科技巨頭掠奪式的數據分利模型,導致其本土產業在未來的利潤分配中面臨長期的結構性邊緣化。
💬 生活化說法
以前你是印度班加羅爾郊區的一名普通家庭主婦,你的工作是去城裡的富裕家庭幫忙打掃、洗碗。你賺取微薄的薪水養活孩子,你對自己工作的理解是純粹的體力勞動,雖然辛苦,但這份技能是你踏踏實實在物理世界生存的本錢,沒有人能輕易奪走,這叫傳統勞動力的肉身護城河(使用前)。現在,實際的場景是,你每天早上來到一個叫『AI數據工廠』的辦公室,穿上特製的背心,胸前掛著一個巨大的 4K 攝像頭。經理要求你像平時一樣去洗碗、抹桌子,但你必須嚴格按照演算法指定的角度移動手臂。你每天看著攝像頭上的綠燈閃爍,將你每一次滑倒、每一次打破盤子的物理反應,實時上傳到微軟或 Google 的海外服務器。你拿到了政府補貼的微薄薪水,高興地覺得這叫科技普惠。然而,你心裡根本不明白,在遙遠的矽谷實驗室裡,科學家們正拿著你出賣的這些洗碗數據,去訓練最新一代的具身智能機器人。三年後,當這些機器人以每小時 1 美元的成本被大量引進印度工廠和富裕家庭時,你戴著攝像頭看著空蕩蕩的招工市場,這才冷酷地懂了:你前幾年賺的每一分錢,都是你親手為自己挖掘墳墓的工資(使用後)。
🏭 產業鏈角度
直接受益者是掌控具身智能核心算法、急需真實物理軌跡數據進行模型微調的全球人形機器人獨角獸與科技巨頭;成本急劇上升的是必須為了承擔印度半導體補貼政策而面臨財政赤字壓力、且缺乏本土終端晶片出貨渠道的印度地方政府;而被擠壓的則是全球其他缺乏人口與成本優勢、無法提供高密度人機協作數據的二線外包勞動市場。
💹 商業觀察角度
.值得觀察的產業環節:資本應配置在「專門提供工業級多模態數據標註軟體平台、且在印度及東南亞擁有排他性特許勞工管理網絡的上市數據要素龍頭」。
.為什麼:因為要在物理環境極其混亂、光照不均的印度小鎮中,精準採集到完全符合具身智能訓練標準的高清動作特徵數據極難(難);印度本土缺乏高階晶片製程人才與基礎設施、其半導體建廠計畫的實質量產進程極慢(慢);而企業要在西方發達國家遵守嚴格勞工法與隱私法的前提下、自建同等規模的人類行為採集團隊其法律與工資成本極貴(貴)。
.觀察指標:必須嚴格驗證印度半導體計畫特許廠房的「單季實際流片出貨量」,以及全球前五大 AI 數據標註平台中來自「具身智能(Embodied AI)」專案的單月營收貢獻率變動。
💡 我們的觀察
要看清這場由擬真語音套現、數位娛樂資產化與肉身數據工廠所交織出的冰冷現實,未來的資產定價將完全取決於「行為改變」的剛性指標。
這裡存在一個在社會損益表上已經無法被掩蓋的生理規律:人類正在全方位向演算法讓渡自己的行為主權,而這種讓渡正在永久性地重塑全球大眾的心理結構與勞動價值。
這絕不是靠幾場科技宣傳或溫馨的就業報告就能粉飾的。我們不能再盲目崇拜虛擬代碼的擴張,必須將所有冷酷的判斷聚焦於人類行為的實體指標變動。我們必須將視角死死鎖定在以下數據上:首先,必須嚴格驗證全球主流社群平台與智慧終端用戶在未來兩季內的「每日平均人機語音通話天數與真實人類社交時間的消長比率」,這將直接證實 GPT-Live 是否正在對人類的群體社交本能進行生理級的折舊與替代;其次,必須密切追蹤 Steam 商店中「中高度使用 AI 資產遊戲」的單季實質玩家留存率(Retention Rate)與退款率,用玩家用錢和時間投票的真實行為,去扯下遊戲產業靈魂至上的虛假面紗;最後,必須鎖定印度數據工廠底層勞工在未來三年內的「轉職率與失業人口變動走勢」,用最殘酷的就業數據,去驗證具身智能數據採集是否是一場以肉身生存為代價的結構性飲鸩止渴。
作者:NineLife AI 編輯室
最後更新:2026年9月9日
本文由 NineLife AI 編輯室整理公開資料後撰寫,可能使用 AI 工具協助草稿整理;發布前會人工檢查來源、事實與語意。內容僅供資訊參考,不構成法律、投資、醫療、稅務或其他專業建議。
站內延伸閱讀:深度閱讀目錄|AI 工具觀察|關於 NineLife AI
留言
張貼留言
留言會先經過審核。歡迎補充觀點或來源;請勿張貼廣告、無關連結、成人、賭博、藥品或自動產生的內容。