🌐 Meta 預設挪用 IG 公開照片進行 AI 二次創作正強行將全網用戶捲入隱私授權的邊界摩擦
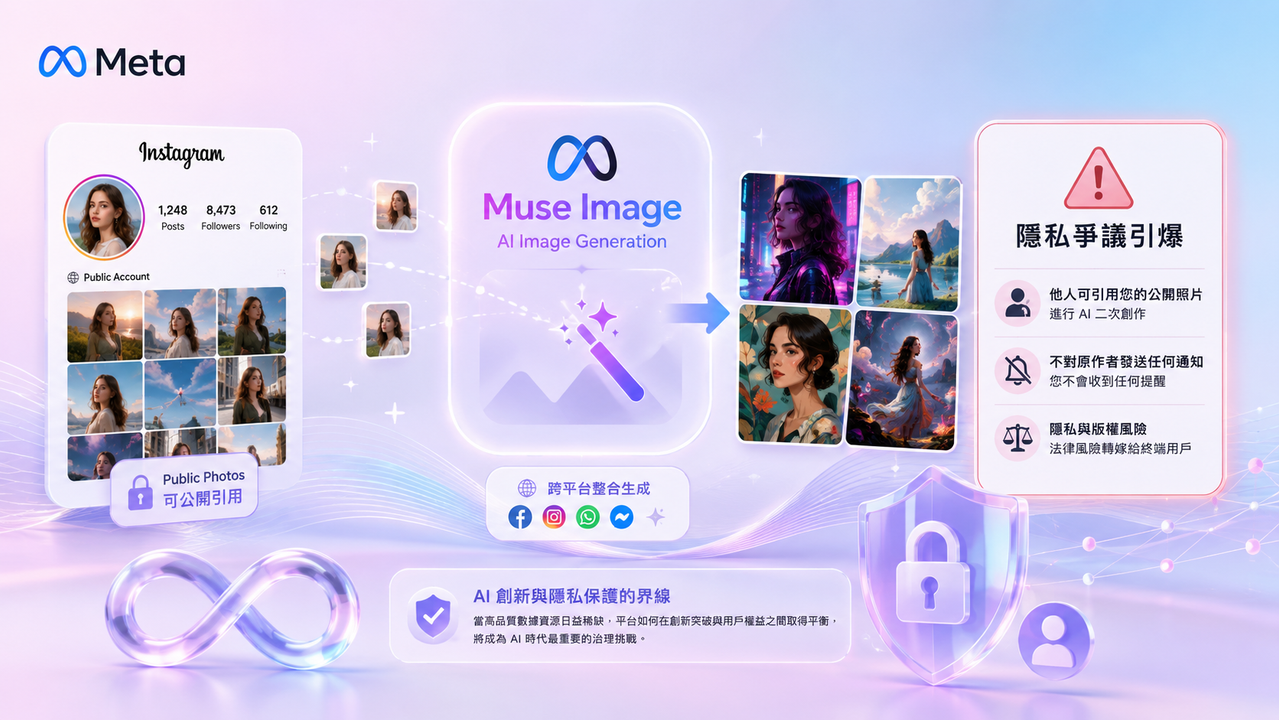
🔹 Muse Image 上線引隱私爭議
📌 新聞內容整理
Meta 正式推出多平台整合的 AI 圖像生成工具 Muse Image,然而其預設允許他人引用用戶公開 Instagram 帳號照片進行 AI 二次創作、且不對原作者進行任何通知的功能,在全球引發巨大的隱私與版權風暴。此事件之所以引發系統限制層面的強烈緊繃,是因為這代表中心化平台在面臨高質量多模態訓練數據枯竭的極限時,正不惜採取越界的授權模式,將法律風險轉嫁給終端用戶,以突破數據牆的系統封鎖。
🔍 知識補充
.技術本質:該功能的技術核心是「基於分散式網絡標籤的跨模態特徵檢索與潛在空間重構(Cross-Modal Feature Retrieval)」。系統直接將用戶的私有視覺編碼(Embedding)暴露在公共生成管線中,使任意第三方皆能調用其肖像權重。
.產業影響:這將徹底破壞 Web2 時代建立的「內容確權基礎」。平台與用戶之間的信任契約發生結構性斷裂,將倒逼整個內容生態系向「全面隱私鎖定」靠攏,反而導致公開互聯網的公域數據加速貧瘠化。
.使用者改變:用戶的社交行為被迫從「公開分享」異化為「防禦性隱私關閉」。使用者為了防止自己的生活照被陌生人任意衍生、甚至遭到惡意篡改,將大面積將帳號轉為私密,終結了社群平台長達十五年的公開流量紅利。
.商業結構:重塑了 Meta 的廣告與數據資產損益表。Meta 試圖用用戶版權肉身,去對沖其購買外部高階藝術數據集的數十億美元授權成本,這種掠奪式商業設計正將合規成本推向系統無法承受的引爆點。
💬 生活化說法
以前你在 Instagram 上發照片,你對這個功能的認知是一個數位生活日記本。你精心修圖、調色,分享你在巴黎度假、或者是家裡小孩的慶生照片,公開帳號是為了獲得朋友的點讚和世界各地的共鳴。平台只是個媒介,照片的智財權和尊嚴牢牢握在你自己手裡,這叫數據主權的黃金時代(使用前)。現在,實際的場景是,你早上醒來打開手機,驚恐地發現一個完全不認識的陌生帳號,用 AI 生成了一張極其逼真的荒謬圖片,裡面的主角竟然是你自己,穿著奇怪的衣服在做著你從未做過的事。原來,Meta 昨晚偷偷上線了 Muse Image,預設把所有人公開的照片都變成了別人的 AI 創作素材,當別人拿著你的臉去任意拼接、修圖時,系統連一封通知信都懶得發給你。你憤怒地翻遍了幾十層複雜的設定選單,才找到那個隱藏極深的關閉按鈕。你這才冷冰冰地看懂了這個平台的限制:只要你還想在這個世界上分享生活,你的肉身和肖像,就註定成為科技巨頭拿去餵養算法的免費燃料(使用後)。
🏭 產業鏈角度
直接受益者是藉由預設授權、在零成本狀態下撈取到數十億張高清人臉與生活場景數據的 Meta AI 核心訓練部門;成本急劇上升的是面臨大規模侵權訴訟風險、必須全面升級審查系統的平台法務與公關團隊;而被擠壓的則是權益被強行稀釋、被迫用個資為平台技術通膨買單的數億名 Instagram 終端創作者。
💹 商業觀察角度
.值得觀察的產業環節:資本應配置在「專注於去中心化內容確權(Decentralized Content Provenance)與主動性加密數位浮水印(Adversarial Watermarking)的上市特許資安架構商」。
.為什麼:因為要在數十億量級的動態多模態數據流中,精準追蹤並全面阻斷未授權的 AI 特徵提取極難(難);各國版權局與最高法院針對 AI 二次創作肖像權的司法立法與合規界定進程極慢(慢);而企業要透過傳統民事訴訟去向中心化科技巨頭索賠個資損失的法律與時間代價極貴(貴)。
.觀察指標:必須嚴格監控Instagram 全球用戶「公開帳號轉私密帳號」的單月轉換率,以及 Meta 因 Muse Image 隱私爭議在歐盟與美國面臨的集體訴訟單季預提法律準備金金額。
🔹 DeepSeek研發AI晶片新策略
📌 新聞內容整理
中國 AI 新創領頭羊 DeepSeek 正全力跨界研發自有 AI 晶片,試圖在推論(Inference)階段擺脫對輝達(Nvidia)以及華為晶片的剛性依賴。然而行業分析明確指出,在當前地緣政治的物理封鎖下,DeepSeek 除非能奇蹟般掌握自主先進製造技術,否則其自研晶片將完全無法進軍海外市場。此事件之所以暴露了系統的極限,是因為它證實了無論軟體算法優化得再精妙,中國 AI 產業最終依舊無法繞過「先進半導體產線產能不確定」這道物理鐵幕的系統限制。
🔍 知識補充
.技術本質:DeepSeek 研發自研晶片的技術本質是「特定算法固化與推論級領域特定架構(DSA)開發」。它試圖將其 Mixture-of-Experts (MoE) 結構的矩陣運算直接寫死在硬體電路上,用架構客製化來彌補製造工藝上奈米數的落後。
.產業影響:這宣告了全球 AI 硬體生態正式走向「區域碎片化(Regional Fragmenting)」。這類新創的突圍,代表非美系 AI 廠商正在放棄通用算力爭奪,轉而全面退守本土市場,在有限的產能沙盒內進行極限的成本內卷。
.使用者改變:B 端開發者的底層調度遭遇「硬體棧分裂(Hardware Stack Splitting)」。開發者未來在部署模型時,無法再用一套 CUDA 代碼走天下,必須針對 DeepSeek 的專有硬體重新編寫底層驅動與算子庫,大幅推升了跨平台遷移的系統磨損。
.商業結構:這扭曲了 AI 晶片製造的重資本模型。一間軟體新創被迫將寶貴的現金流砸向風險極高、折舊極快的晶片設計研發,這種被迫的「重資產化」將極大壓榨其軟體研發的毛利與現金儲備。
💬 生活化說法
以前你是一家頂級 AI 新創的首席架構師,你對技術的理解是純粹的數學和代碼。你不用管硬體,因為市場上有充足的輝達晶片供你租賃。你只需要專注於把模型參數調優、把算法寫到極致,晶片效能會隨著台積電的製程推進每十四個月自動翻倍,這叫軟體吞噬世界的線性紅利(使用前)。現在,實際的場景是,你每天開會討論的不再是算法,而是公司必須自己撥出幾億美金,去跟設計公司、代工廠談晶片流片。你在辦公室裡看著設計圖紙,心裡清楚得很,因為拿不到最先進的極紫外光(EUV)微影設備代工,你們自研出來的晶片體積比別人大三倍、功耗高五倍。當別國的同行正在用最新的製程進行萬億參數推理時,你卻必須帶著團隊在老舊的工藝制程上限裡,痛苦地去優化代碼,試圖用硬體架構的變形去對沖物理製程的代差。你這才看懂了系統的冰冷牆壁:在晶片物理學面前,再聰明的代碼也無法憑空變出光刻機(使用後)。
🏭 產業鏈角度
直接受益者是獲得 DeepSeek 巨額訂單與前期設計研發授權費用的本土晶片設計服務商與成熟製程代工廠;成本急劇上升的是被迫在軟體之外、承擔極高流片失敗(Tape-out Failure)風險與晶片資產折舊的 DeepSeek 自身;而被擠壓的則是缺乏本土硬體適配能力、無法切入該專有生態的二線軟體應用商。
💹 商業觀察角度
.值得觀察的產業環節:資金應配置在「卡位成熟製程晶片良率提升、且具備特定 AI 算子硬體 IP 授權能力的特許半導體檢測與 IP 供應商」。
.為什麼:因為要在完全缺乏最先進代工工藝的前提下,憑空製造出能與輝達推論效能抗衡的專用晶片極難(難);本土半導體供應鏈從設計、封裝到材料全面去美化的技術驗證進程極慢(慢);而重啟一條完全不受外部制約、且具備經濟效益的晶片産線其資本開銷與時間風險極貴(貴)。
.觀察指標:必須嚴格驗證DeepSeek 自研晶片的「首批流片良率(Yield Rate)」與「單晶圓推論能效比(Perf-per-Watt)」,以及其在本土代工廠的單季產能排單量。
🔹 AI新模型惹抱怨,使用體驗堪憂
📌 新聞內容整理
Anthropic 剛推出的全新一代旗艦模型 Claude Sonnet 5,雖然在官方基準測試中宣稱各項指標全面超越前代,但一上線隨即遭到全球開發者與付費用戶的強烈投訴。使用者指出,該模型在實際高強度作業中,頻繁出現過度質疑用戶指令、記憶鏈異常中斷、以及輸出大量無關提示與錯誤代碼的現象。此事件之所以引發熱議,是因為它揭露了大型語言模型在追求絕對安全的對抗性對齊(Alignment)時,正撞上「模型邏輯容量過載」的系統崩潰極限。
🔍 知識補充
.技術本質:體驗崩潰的技術本質是「過度安全對齊引發的內部特徵坍塌(Alignment-induced Representation Collapse)」。Anthropic 為防止模型被提示詞注入攻擊,在底層加入了過於嚴苛的過濾權重,這直接導致模型的推理注意力機制(Attention Mechanism)發生扭曲,將正常商務指令誤判為惡意攻擊。
.產業影響:這宣告了大模型靠擴大規模(Scaling Laws)來無痛提升體驗的範式遭遇阻礙。當模型複雜度達到臨界點,安全防禦機制與通用推理能力之間的系統性衝突將全面爆發,導致產品商用穩定度急劇下降。
.使用者改變:開發者的工程體驗從「自動化代碼生成」異化為「人機語意拉扯」。工程師發現自己花在與 AI 解釋意圖、糾正其記憶錯誤的時間,已經遠遠超過自己親自寫代碼的時間,技術工具實質上變成了生產力累贅。
.商業結構:重創了基於 Claude API 的 B 端應用生態之商業基石。由於底層模型的穩定度發生非線性崩潰,導致所有將業務掛載其上的軟體公司,其產品在終端用戶面前頻繁發生任務中斷,引發連鎖的商譽受損與退款潮。
💬 生活化說法
以前你每個月準時支付 20 美金訂閱 Claude,你對它的期待是一個絕對服從、智商極高的全能數位助理。你把晦澀的法律合約、幾萬行的代碼丟給它,它能一秒看穿漏洞並給出精準的修正建議,你只需要複製貼上,工作效率提升三倍,這叫大模型技術爆發的甜蜜期(使用前)。現在,實際的場景是,你打開最新的 Claude Sonnet 5,敲入一段完全合法的數據庫串接指令。它沒有像以前一樣立刻給出代碼,反而跳出一大段冷冰冰的話,嚴厲地質問你為什麼要調用這個數據、這是不是在進行黑客攻擊。你耐著性子跟它解釋了三輪,它終於開始寫代碼,卻在寫到一半時突然忘記了你前天剛跟它對齊過的業務邏輯,甚至塞給你一堆完全不相干的亂碼。你坐在電腦前看著不斷轉圈的錯誤提示,發現自己下午原本要交差的專案已經徹底延誤,你氣得想摔鍵盤。這才看懂了演算法的系統死局:當這個機器被人類教得越來越『小心翼翼』的時候,它也就同時變成了一個無法正常工作的神經質廢物(使用後)。
🏭 產業鏈角度
直接受益者是在此混亂期內、能憑藉較低安全限制和極高商業穩定度瘋狂搶奪 API 流量的微軟與 OpenAI 生態圈;成本急劇上升的是因為底層模型頻繁中斷、必須徹夜重構錯誤處理管線(Error Handling Pipelines)的 B 端軟體開發商;而被擠壓的則是付出了高昂訂閱費、卻換來生產力嚴重倒退的全球付費用戶。
💹 商業觀察角度
.值得觀察的產業環節:資金應堅決降低曝險任何將核心產品純寄生於單一閉源大模型 API 的輕資產軟體股,將資金配置在「提供獨立大模型行為審計、並具備動態中間件(Middleware)路由切換能力的上市系統整合商」。
.為什麼:因為要在不破壞通用推理能力的前提下,完美解決大模型安全對齊與使用者體驗之間的剛性衝突極難(難);大型模型廠商從收集用戶反饋到真正完成底層權重微調修正的迴圈進程極慢(慢);而企業因為底層模型崩潰、導致上層商業系統停機所造成的營運淨值損失與修復成本極貴(貴)。
.觀察指標:必須嚴格驗證GitHub 上關於「Claude 5 API 報錯與中斷」的單週 Issue 新增數量,以及 Anthropic 核心企業客戶在「單季 API 流量續簽率」的變動數據。
💡 我們的觀察
要看清這場由 Meta 數據掠奪、DeepSeek 硬體自救與 Anthropic 體驗崩潰所交織出的底層現實,未來的資產定價將完全取決於「指標驗證」的剛性清算。
這裡存在一個在財務損益表上已經無法被掩蓋的冰冷物理規律:AI 技術的演進正在全面撞擊其實體世界的系統限制牆壁,任何試圖忽略硬體、地緣與模型邏輯天花板的估值泡沫都將面臨重力修正。
這絕不是靠幾場宣傳或精美的基準測試圖表就能掩蓋的。我們必須將所有冷酷的判斷鎖定在實體指標上:首先,必須嚴格驗證 Meta 因 Muse Image 爭議在未來兩季內所面臨的「歐盟 GDPR 與各國集體訴訟的判決與罰款金額」,這直接錨定了平台以隱私換數據的成本臨界點;其次,必須密切追蹤 DeepSeek 自研晶片在本土代工廠的「首批流片良率與每片晶圓的實質推論成本」,用物理製造的真實數據去撕開成熟製程突圍的敘事面紗;最後,必須鎖定全球前五百大軟體公司在「Claude 5 API 調用量上的單季續簽率變動」,用開發者用錢投票的真實流量,去判定大模型是否正因過度安全對齊而陷入生產力衰退的死局。
作者:NineLife AI 編輯室
最後更新:2026年9月9日
本文由 NineLife AI 編輯室整理公開資料後撰寫,可能使用 AI 工具協助草稿整理;發布前會人工檢查來源、事實與語意。內容僅供資訊參考,不構成法律、投資、醫療、稅務或其他專業建議。
站內延伸閱讀:深度閱讀目錄|AI 工具觀察|關於 NineLife AI
留言
張貼留言
留言會先經過審核。歡迎補充觀點或來源;請勿張貼廣告、無關連結、成人、賭博、藥品或自動產生的內容。