騰訊升級暑期防沉迷措施導致生物識別邊緣審查剛性常態化
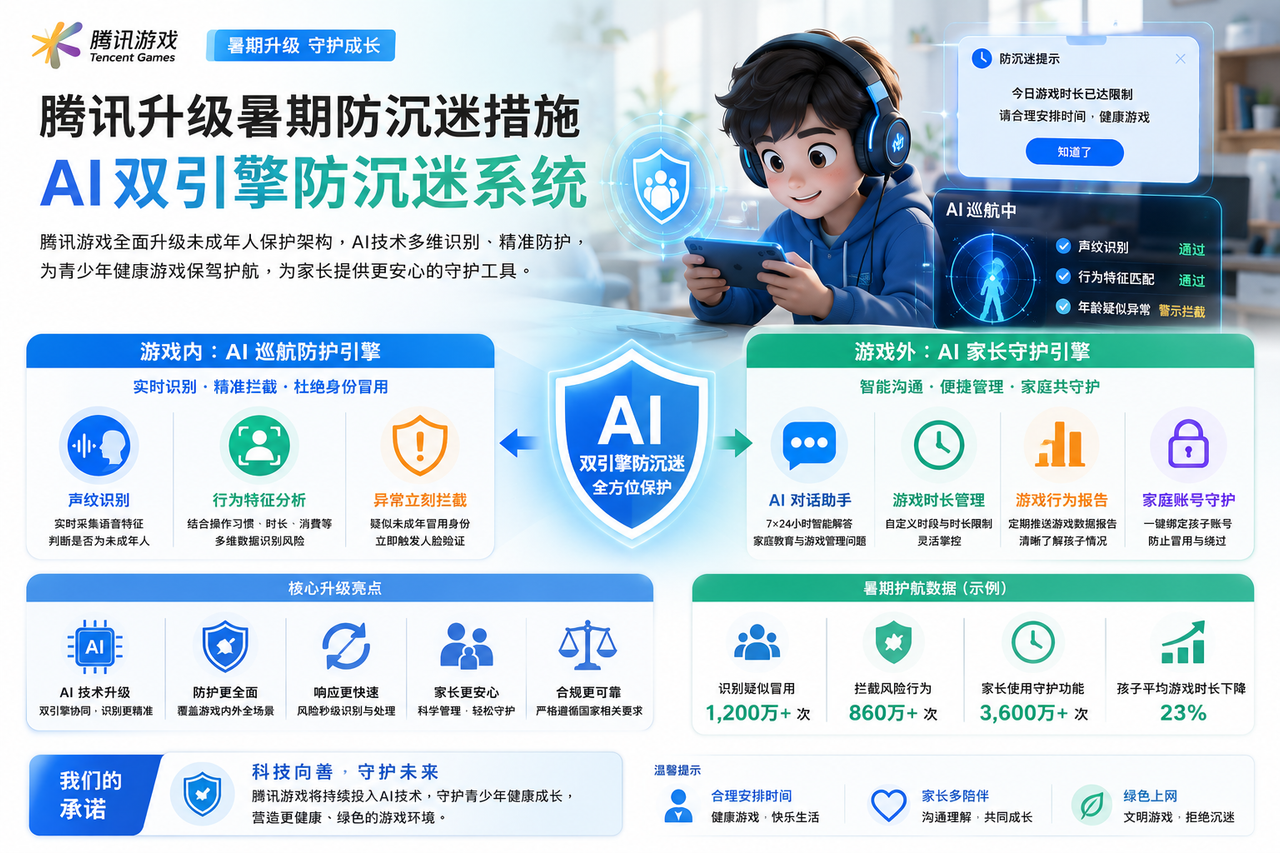
🔹 騰訊升級暑期防沉迷措施
📌 新聞內容整理
隨著暑期用戶活躍度攀升,騰訊遊戲宣布啟動全新未成年人保護架構,全面導入「AI 雙引擎防沉迷」系統。該技術透過 AI 巡航功能,在遊戲內實時調用聲紋與年齡行為特徵辨識,以封堵身份冒用漏洞;遊戲外則提供 AI 對話介面供家長實施家庭帳號守護。此舉之所以被市場重度檢視,是因為這代表互聯網巨頭必須將極高昂的即時算力,從創造利潤的推廣端,剛性移轉至防禦政治合規風險的邊緣審查端。
🔍 知識補充
.技術本質:該防沉迷架構底層是「多模態行為熵值與動態聲紋特徵交叉比對(Multimodal Behavioral Entropy & Voiceprint Cross-verification)」。系統在後台持續監測玩家的輸入頻率、視角轉動慣性,並與聲紋頻譜即時比對,判定操作者是否為非註冊主體的未成年人。
.產業影響:這大幅拉高了遊戲營運的基礎算力門檻。每一次玩家登入與高頻互動,都伴隨著非營利性的 AI 權限審查,這將導致遊戲廠商的後台伺服器帶寬與算力消耗出現非資產化的淨流出。
.使用者改變:玩家的數位隱私邊界被迫全面退讓。使用者為了獲得合法的娛樂特許權,必須容忍系統常駐後台進行生物特徵與聲音的即時抓取,用戶體驗從「無感接入」轉向「高壓監控下的特許准入」。
.商業結構:重塑了遊戲軟體的變現天花板。當未成年帳號被 AI 剛性隔離,黑市租號與代理代儲的灰色產業鏈將被徹底清算,倒逼遊戲商必須將獲利模型全盤向高淨值的成年付費用戶極端集中。
💬 生活化說法
以前你在放假期間玩線上遊戲,只要拿家裡長輩的身份證號碼過一下註冊防線,系統就不會再管你。你可以在遊戲裡通宵暢玩、瘋狂購買虛擬裝備,甚至在聊天室裡跟隊友用語音打屁,整個遊戲過程流暢且沒有任何干擾,只要不觸碰核心敏感詞,沒人知道螢幕後面到底是誰(使用前)。現在,實際的場景是,你剛點開遊戲準備和朋友組隊,耳機裡突然跳出一個 AI 提示語音要求你覆誦一段文字。就在你說話的千分之幾秒內,騰訊的後台系統已經把你的聲紋頻譜、講話的抖音程度,跟你大腦操控滑鼠的微小肌肉反射速度全部算了一遍。只要它判定你講話的聲帶發育還不滿十八歲,你的螢幕會在一秒鐘內直接變黑並強制登出。你就算拿著長輩的實體身份證也沒用,因為演算法不看紙本,它只相信你的生物數據。你被迫放下手機,你的娛樂權利被這套無處不在的 AI 巡航系統徹底閹割(使用後)。
🏭 產業鏈角度
直接受益者是提供高級聲紋生物識別技術、加密身份驗證閘道器的特許資安廠商;成本顯著上升的是必須承擔天價非營利性審查算力開銷的遊戲運營商;而被擠壓的則是純靠盜版租號、代刷身份維生的黑產中介。
💹 商業觀察角度
.值得觀察的產業環節:資金應配置在「專門研發邊緣端低延遲生物特徵加密晶片、且能直接嵌入行動硬體底層的上市半導體上游大廠」。
.為什麼:因為要在玩家毫無感知的毫秒級延遲內完成聲紋與行為熵值的交叉推理極難(難);各國針對未成年生物數據收集與隱私權邊界的立法聽證進程極慢(慢);而企業要在每秒幾百萬併發流量下自建一套完全不產生誤判的 AI 巡航審查系統硬體成本極貴(貴)。
.觀察指標:必須嚴格監控騰訊單季財報中「非遊戲業務之伺服器與基礎設施折舊費用」的增幅變動,以及全球主流應用商店中「第三方家長控制/行為審計軟體」的單月下載增長率。
🔹 Spotify AI計畫惹網友猛烈批評
📌 新聞內容整理
數位串流巨頭 Spotify 日前高調宣示其與 Anthropic 合作的 AI 輔助開發計畫,指出在 AI 工具的協助下,公司每日代碼部署次數已飆升至 4,500 次,且有近八成的代碼更新皆由 AI 參與。然而,此舉卻在社群引發大量核心用戶的憤怒抵制與產業界強烈質疑。使用者普遍反映日常功能並未因高頻更新而獲得提升,反而導致應用程式卡頓與介面逻辑混亂,揭穿了開發端虛假的高頻產出與用戶端實質體驗折舊之間的巨大落差。
🔍 知識補充
.技術本質:每日 4,500 次部署的本質是「代碼膨脹與回歸測試失效(Code Bloat & Regression Testing Failure)」。當大模型被大量用於自動生成補丁時,雖然單一函數的產出速度極快,但在缺乏人類架構師全局觀的狀況下,代碼與代碼之間的非線性耦合(Coupling)會急速增加,導致軟體系統的技術債(Technical Debt)呈指數級堆疊。
.產業影響:這徹底打破了「代碼產量等於研發效率」的傳統神話。軟體工程的評估標準被迫重新修正,若缺乏嚴格的人類架構審查,AI 自動生成的代碼更新只會加速軟體系統的混亂與崩潰。
.使用者改變:用戶的數位體驗進入「頻繁修復焦慮」。使用者每天點開 App 都要面對微小的介面變動與莫名其妙的閃退錯誤,被迫花費時間去重新適應毫無意義的代碼更新。
.商業結構:這扭曲了軟體 SaaS 的價值基礎。當八成代碼由 AI 堆砌且未帶來體驗溢價時,用戶將拒絕為軟體商高昂的研發預算買單,引發產品訂閱率的潛在流失。
💬 生活化說法
以前你用 Spotify 聽音樂,App 的介面兩年才大改版一次。雖然更新慢,但每一次改版都是設計師反覆推敲的結果,播放鍵在哪裡、歌單怎麼分類都非常符合人類的直覺。你每天點開它,它就像一個沈穩安靜的音響,從不給你添亂,你放心地每年續訂,這叫穩定的軟體服務(使用前)。現在,實際的場景是,你早上通勤剛戴上耳機,點開 App 發現介面又變了,原本隨手能點到的搜尋欄被移到了最角落,當你想點擊播放時,畫面直接卡死三秒。因為在過去二十四小時內,Spotify 的 AI 已經自動在後台進行了四千多次代碼部署。這堆由機器人自己寫、自己審查、自己發布的代碼補丁,像癌細胞一樣在你的手機記憶體裡瘋狂打架。你只是想聽首音樂,卻被迫成為了這場虛擬代碼通膨的免費除錯白老鼠。你憤怒地看著發燙的手機,直接在社群上留下一星差評,大喊叫他們的工程師把 AI 關掉(使用後)。
🏭 產業鏈角度
直接受益者是按 Token 流量和計算時間向 Spotify 收取天價雲端算力費用的底層大模型廠商與雲端基礎設施商;成本顯著上升的是在混亂代碼中被迫承擔系統除錯與士氣崩潰的基層工程師;而被擠壓的則是付出真金白銀訂閱費用卻換來劣質產品體驗的終端消費者。
💹 商業觀察角度
.值得觀察的產業環節:資金應堅決撤出任何盲目誇耀「AI 代碼生成率」、且缺乏實體用戶營收溢價的純軟體概念股,將資金打在「專門提供自動化代碼質量靜態深層審計(Static Code Analysis)與架構風險阻斷的上市資安大廠」。
.為什麼:因為要在每天 4,500 次的暴力代碼洪流中精準抓出隱蔽的語意邏輯衝突極難(難);大型軟體企業從「數量崇拜」回歸到「質量合規」的官僚修正進程極慢(慢);而系統因為 AI 代碼通膨引發全線癱瘓、被迫全盤重構的實體財務代價極貴(貴)。
.觀察指標:必須密切追蹤微軟 GitHub Copilot 與 Anthropic 在企業端續訂率的變動走勢,以及 Spotify 單季用戶「非自然流失率(Churn Rate)」與產品技術債攤提費用的增減。
🔹 AI用電激增,服務業轉型新契機
📌 新聞內容整理
能源署最新統計數據暴露出一個冷峻現實:隨著 AI 技術從製造業全面向搜尋、客服及影音串流等服務業滲透,導致出版、資通訊等第三產業的資料中心與網絡基礎設施用電量出現非理性激增。目前服務業總用電量已高居全台第三,僅次於工業與住宅。更為嚴峻的是,現有的電力統計架構根本無法精準拆解與追蹤「因 AI 運算而淨增加」的電網負荷,這直接將能源供應的物理瓶頸,轉化為全行業轉型時不得不面對的剛性成本黑洞。
🔍 知識補充
.技術本質:服務業用電暴增的底層邏輯是「數據傳輸與實時推理的熱力學折舊(Thermodynamic Depreciation)」。用戶每一次線上搜尋、每一秒串流渲染,在後台都需要資料中心機房消耗實體電力進行電壓切換,並產生天價的冷卻散熱能耗。
.產業影響:這打破了服務業作為「輕資產、低能耗」行業的傳統會計定義。當出版與資通訊業的營運高度綁定大模型時,這些企業的獲利結構將直接與國家電價波動及供電穩定度發生剛性利害連動。
.使用者改變:企業決策層被迫進入「能源配給制思考」。高階主管在評估上線新 AI 功能時,不能再唯效率論,必須將電網負荷與本地機房的供電容積作為剛性卡位的前置指標。
.商業結構:這重組了數位服務業的競爭邊界。未來缺乏綠能特許採購特權、或無法自主優化模型算法能耗比的中小型軟體商,其利潤空間將直接被暴漲的電費帳單無情吞噬。
💬 生活化說法
以前你在台灣經營一家中型的數位出版與資通訊服務公司,你的辦公室裡除了員工的電腦、幾台影印機和全天候的冷氣之外,幾乎沒有任何大型耗電設備。每個月的電費帳單固定且低廉,你相信只要專注於優化網頁內容與線上客服,你的公司就是最環保、毛利最高的輕資產代表(使用前)。現在,實際的場景是,你為了推動數位轉型,把公司所有的文章庫、客戶語音紀錄全部對接了雲端 AI 智慧搜尋功能。結果到了夏天,能源署和台電的人突然面色凝重地登門拜訪,拿著帳單警告你們出版業的用電增長率已經拉高了整條街的電網負載。你打開財務報表一看,發現因為用戶高頻調用影音串流與實時語意推理,你們租用的本地資料中心費用直接翻了三倍,裡面有一大半都是在幫伺服器的冷氣電費買單。你坐在辦公桌前看著見底的現金流,才驚覺原來在虛擬世界裡按個按鈕,在實體世界裡是要用幾百萬度電去剛性清算的,你的輕資產神話當場破產(使用後)。
🏭 產業鏈角度
直接受益者是掌控綠電躉購特許權、高密度機房散熱(液冷系統)組件以及智慧電網量測特利專利的實體工業巨頭;成本顯著上升的是必須為數據通膨支付高昂電費溢價的數位資通訊與出版營運商;而被擠壓的則是完全缺乏節能微調技術、毛利被電費榨乾的二線雲端套殼軟體店。
💹 商業觀察角度
.值得觀察的產業環節:資本應堅決配置在「專門提供資料中心高階重力熱管與晶片級液冷(Liquid Cooling)散熱系統、且具備跨國一線伺服器廠特許認證的上市硬體龍頭」。
.為什麼:因為要在大數據流量無規律爆發的狀況下精準分離並預測 AI 淨增用電量極難(難);各國電網基礎設施擴建與能源法規統計架構的更新進程極慢(慢);而企業因為供電不穩導致資料中心停機或電費失控的實體清算開銷極貴(貴)。
.觀察指標:必須嚴格監控能源署每季公布之「出版、資通訊及服務業用電量年增率」的斜率變動,以及全球大型 CSP(雲端服務提供商)在散熱硬體採購上的 CapEx 預算佔比。
💡 我們的觀察
從騰訊將高昂算力剛性用於「AI雙引擎防沉迷」的合規防禦、到 Spotify 盲目追求每日 4,500 次部署卻換來用戶體驗破產的代碼通膨,再到台灣服務業因 AI 數據運算引發出版與資通訊用電暴增的物理極限,我們站在產業鏈底層與基礎能源的透視視角,看清的是正在落地的「成本落點」。
這裡存在一個在財務損益表上已經無法被掩蓋的冰冷物理規律:全球 AI 技術的盲目擴張,其真實成本從未憑空消失,而是正在被實體世界剛性地攤提為「互聯網巨頭為了政治合規而付出的非資產化算力折舊」、「軟體商為了修復 AI 垃圾代碼而被迫拉長的研發週期」,以及「服務業為了承接虛擬運算而向電網支付的天價能源帳單」。
作者:NineLife AI 編輯室
最後更新:2026年9月9日
本文由 NineLife AI 編輯室整理公開資料後撰寫,可能使用 AI 工具協助草稿整理;發布前會人工檢查來源、事實與語意。內容僅供資訊參考,不構成法律、投資、醫療、稅務或其他專業建議。
站內延伸閱讀:深度閱讀目錄|AI 工具觀察|關於 NineLife AI
留言
張貼留言
留言會先經過審核。歡迎補充觀點或來源;請勿張貼廣告、無關連結、成人、賭博、藥品或自動產生的內容。